Un company brain rassemble tout ce que votre entreprise sait, ce qui se trouve dans les docs, dans la tête des gens et éparpillé entre vos outils, et le rend exploitable sous forme de réponses ou de contexte. Pour les personnes comme pour les agents.
Si le terme est nouveau pour vous, commencez par notre définition complète et l'histoire de ses origines, puis revenez ici.
La catégorie a à peine six mois, et des dizaines d'entreprises veulent désormais être le company brain.
Certaines sont des dépôts open source avec quelques centaines d'étoiles. D'autres sont des bibliothèques de mémoire pour développeurs. D'autres encore sont des projets internes qui n'ont jamais été conçus pour être vendus. Et quelques-unes sont des produits dédiés.
Toutes répondent au même cahier des charges, mais sous des formes très différentes.
Pendant ce temps, la plupart des équipes n'en ont pas. Lorsque nous avons interrogé 149 équipes en juillet 2026, seules 17 % ont répondu avoir un company brain qui fonctionne. 27 % de plus ont essayé d'en construire un et ont abandonné, presque toujours à cause de la maintenance plutôt que de la technologie.
Pour notre étude Company Brain 101, nous avons donc testé et analysé une douzaine de produits qui se présentent comme des solutions de company brain, et interviewé plus de dix personnes qui en construisent actuellement.
Points clés
- Chaque solution de company brain, open source ou commerciale, se décompose en quatre mêmes composants : capter les signaux, mémoriser, rêver et élaguer, et parler et chercher.
- Le marché se divise en quatre familles : modèles auto-hébergés, SDK de mémoire, acteurs établis intégrés et company brains dédiés. Chacune arbitre différemment entre entretien humain et coût de calcul.
- Le composant qui distingue un company brain qui marche d'un wiki périmé, c'est la maintenance. Seuls quelques-uns des outils étudiés l'automatisent, et tous gardent un humain dans la boucle.
- Seules 17 % des équipes interrogées ont un company brain qui fonctionne. La précision (77 %) et les permissions (63 %) sont les préoccupations qui déterminent la famille à choisir.
- Si vous avez des ingénieurs motivés et moins de 50 personnes, auto-hébergez. Si vous construisez vos propres agents, utilisez un SDK de mémoire. Tous les autres ont besoin d'un company brain dédié qui automatise l'entretien sans enfermer votre contexte dans une seule plateforme.
Chaque company brain repose sur les mêmes quatre composants
Nous avons examiné de l'intérieur une douzaine de solutions de company brain pour notre ebook, open source et commerciales, personnelles et pour toute l'entreprise, construites en interne et achetées. Elles diffèrent presque partout.
Sauf sur un point. Chacune est construite à partir des mêmes quatre composants. Le brain capte des signaux, il mémorise, il rêve et élague, et il parle quand on lui parle.
Capter les signaux
Capter les signaux, c'est la façon dont le brain apprend ce qui s'est passé aujourd'hui dans l'entreprise. Un flux régulier lui permet de décrire votre entreprise telle qu'elle est maintenant, que ce soit une personne qui l'interroge ou un agent qui y puise du contexte.
Les outils et les systèmes de référence comme votre CRM, votre gestion de projet, votre messagerie et vos outils de développement produisent de l'activité à des rythmes et des volumes différents. Les méthodes de capture arbitrent donc entre fraîcheur, coût et bruit.
Quatre approches couvrent le terrain :
- Récupérations planifiées. Un connecteur synchronise chaque outil à intervalle fixe. Utile pour les sources à évolution lente comme les docs et les fiches CRM.
- Capture d'événements. Un webhook envoie chaque événement au brain à l'instant où il se produit. Utile pour les sources rapides comme la messagerie et les tickets.
- Ingestion par agent. Un agent lit une source, retient l'essentiel et écrit un résumé structuré dans le brain. Utile pour les sources bruyantes comme les transcriptions de réunions.
- Récupération au moment de l'inférence. Rien n'est stocké. Le brain interroge les sources en direct à l'instant où une question arrive. Utile quand le système source doit rester la seule copie.
Mémoriser
Mémoriser, c'est la forme sous laquelle le brain stocke la connaissance pour qu'on puisse la retrouver. Cette forme détermine les questions auxquelles le brain saura répondre plus tard.
Les formes plus riches répondent à davantage de questions, mais coûtent plus cher à construire et à maintenir, ce qui explique que quatre coexistent :
- Fichiers simples. Du Markdown dans un dépôt git, lisible par n'importe quel humain et n'importe quel agent. Utile pour les petites équipes techniques qui ne veulent aucune infrastructure.
- Documents. Une base de connaissances avec des responsables et des permissions. Utile quand les lecteurs principaux sont des humains.
- Index vectoriel. Tout est vectorisé et recherché par le sens plutôt que par mots-clés. Utile pour de gros volumes de contenu non structuré.
- Graphe de connaissances. Des entités et des relations stockées sous forme d'arêtes typées, avec dans les versions les plus riches une fenêtre de validité sur chaque fait. Utile quand les questions portent sur des relations ou un historique.
Certains brains combinent volontairement deux de ces formes : des docs lisibles pour les humains, plus un niveau structuré dense que seuls les agents ouvrent.
Rêver et élaguer
Rêver et élaguer, c'est la façon dont le brain maintient à jour les connaissances de l'entreprise sans qu'on le lui demande.
- « Rêver » est emprunté au cycle de rêve nocturne de GBrain : une tâche planifiée où le brain relit ce qu'il a appris dans la journée, le réorganise et le relie à nouveau, comme le sommeil consolide la mémoire.
- Élaguer est l'autre moitié, qui consiste à retirer ce qui ne tient plus.
Le contexte d'entreprise devient obsolète de différentes façons :
- par l'âge,
- par le manque d'usage,
- ou par contradiction avec ce qui se passe réellement dans vos outils.
Chaque cas demande sa propre routine :
- Passes de consolidation. Une tâche planifiée réorganise et relie tout ce qui est arrivé dans la journée. Utile pour garder une mémoire cohérente à mesure qu'elle grossit.
- Décroissance dans le temps. Les faits anciens et inutilisés perdent du poids dans la recherche, ou expirent purement et simplement. Utile contre le vieillissement silencieux.
- Détection des écarts. Le brain compare ce qu'affirment les docs avec l'activité réelle dans les outils connectés et signale les écarts. Utile pour repérer les pages que la réalité a laissées derrière elle.
- Files de relecture. Chaque modification proposée par le brain attend dans une boîte de réception l'approbation d'un humain. Utile partout où une mauvaise mise à jour coûte plus cher qu'une mise à jour lente.
Parler et chercher
Parler et chercher, c'est là que tout se rejoint : l'endroit où les gens cherchent vraiment, et l'endroit où les agents puisent du contexte. Chaque demandeur a besoin de sa propre porte. Les humains veulent une conversation. Les machines veulent un point d'accès.
- Chat. Des questions en langage naturel, des réponses avec citations renvoyant aux sources. Utile pour les questions quotidiennes de l'équipe.
- Recherche hybride. Rechercher par le sens et par mot-clé exact en même temps, puis réordonner les résultats. Utile comme mécanique sous-jacente de tous les autres modes.
- API headless ou MCP. Le brain exposé comme un point d'accès que d'autres systèmes interrogent directement. Utile pour brancher le brain sur des agents de code, des bots de support et des workflows.
- Applications dédiées. Des interfaces conçues pour une équipe ou un workflow précis. Utile quand un cas d'usage mérite sa propre surface.
Aucune solution ne fait tout cela à la fois. Chacune choisit une seule option par composant, et ce sont ces choix qui font que deux company brains se comportent de façon totalement différente.
| Capter les signaux | Mémoriser | Rêver et élaguer | Parler et chercher |
|---|---|---|---|
| Récupérations planifiées par connecteurs | Markdown simple dans un dépôt git | Passes de consolidation nocturnes | Chat avec citations |
| Webhooks et capture d'événements | Docs de wiki ou de base de connaissances | Décroissance dans le temps et expiration des faits | Recherche hybride |
| Ingestion par agent qui structure les sources | Index vectoriel sur l'ensemble | Détection des écarts par rapport aux outils en direct | API headless / MCP vers d'autres outils |
| Récupération au moment de la question, rien n'est stocké | Graphe de contexte ontologique ou temporel | File de relecture humaine pour chaque modification | Interfaces d'applications dédiées |
Les quatre familles de solutions de company brain
Chaque solution du marché fait un compromis différent entre les cinq préoccupations que nos répondants ont citées le plus souvent : la précision (77 %), la confidentialité et les permissions (63 %), la charge de maintenance (58 %), le coût de l'ingestion et de la maintenance au quotidien (58 %) et l'effort de mise en place (33 %). La façon la plus claire de voir ce compromis est de comparer les coûts entre eux : ce que vous payez en entretien humain contre ce que vous payez en calcul et en abonnements.
Représenté ainsi, le marché se divise en quatre familles.
| Famille | Pour qui | Ce qu'elle apporte | Ce qu'elle vous coûte |
|---|---|---|---|
| Modèles auto-hébergés (GBrain, Sylph, construits en interne) | Équipes techniques qui veulent une souveraineté totale | Open source, fichiers simples, coût d'exploitation quasi nul, portabilité totale | La maintenance retombe entièrement sur vos équipes. C'est l'histoire des 27 %. |
| SDK de mémoire (mem0, Letta, Zep) | Ingénieurs qui construisent leurs propres agents | Briques open-core, extraction automatique, graphes temporels | Vous assemblez et réglez vous-même tout ce qui se trouve au-dessus de la couche de mémoire |
| Acteurs établis intégrés (Notion AI, Rovo, Slack AI, Glean, ChatGPT et Claude Enterprise) | Organisations qui vivent déjà dans une seule suite | Mise en place la plus simple, permissions gérées d'emblée | Verrouillage du contexte : votre brain appartient à la plateforme |
| Company brains dédiés (Slite Agent, Carrara, Pletor) | Équipes qui veulent une couche indépendante des modèles et des plateformes | Maintenance automatisée avec relecture humaine, portabilité comme fonctionnalité | Un abonnement, et vous confiez toute la couche à un éditeur |
La plupart des équipes ont déjà une version de la troisième famille. Chaque grande plateforme construit un brain à partir de la part de contexte qu'elle détient déjà :
- Salesforce avec Slack AI,
- Atlassian avec Rovo,
- Notion avec Notion AI,
- Microsoft et Google dans leurs suites,
- OpenAI et Anthropic du côté des modèles.
Ce sont les plus rapides à activer. Le piège, c'est ce que nous appelons le verrouillage du contexte.
Un company brain doit lire à travers toutes les sources, ce qui signifie que celui qui l'exploite détient la version la plus complète et la plus portable de votre entreprise qui ait jamais existé en un seul endroit.
Quand cette couche appartient à une plateforme que vous ne pouvez pas quitter, vous payez ce verrouillage dans chaque réponse, chaque agent et chaque workflow construit par-dessus.
Le resserrement est déjà visible : depuis la mi-2025, les outils tiers ne peuvent plus indexer en masse les messages Slack, et les applications hors Marketplace sont limitées en débit et ne peuvent pas conserver l'historique.
Le même compromis apparaît avec de nombreux outils natifs des suites, ce qui explique pourquoi les équipes se mettent à chercher des alternatives dès que le verrouillage devient coûteux.
10 solutions de company brain et ce que chacune utilise vraiment
Pour chaque outil : ce que c'est, à qui il s'adresse, et ses quatre choix de composants, tirés de la documentation publique et, quand nous avons pu les obtenir, d'entretiens avec les personnes qui le construisent. Les entrées sont regroupées par famille, sans classement particulier.
Modèles auto-hébergés
1. Construit en interne : Claude Code + un dépôt git
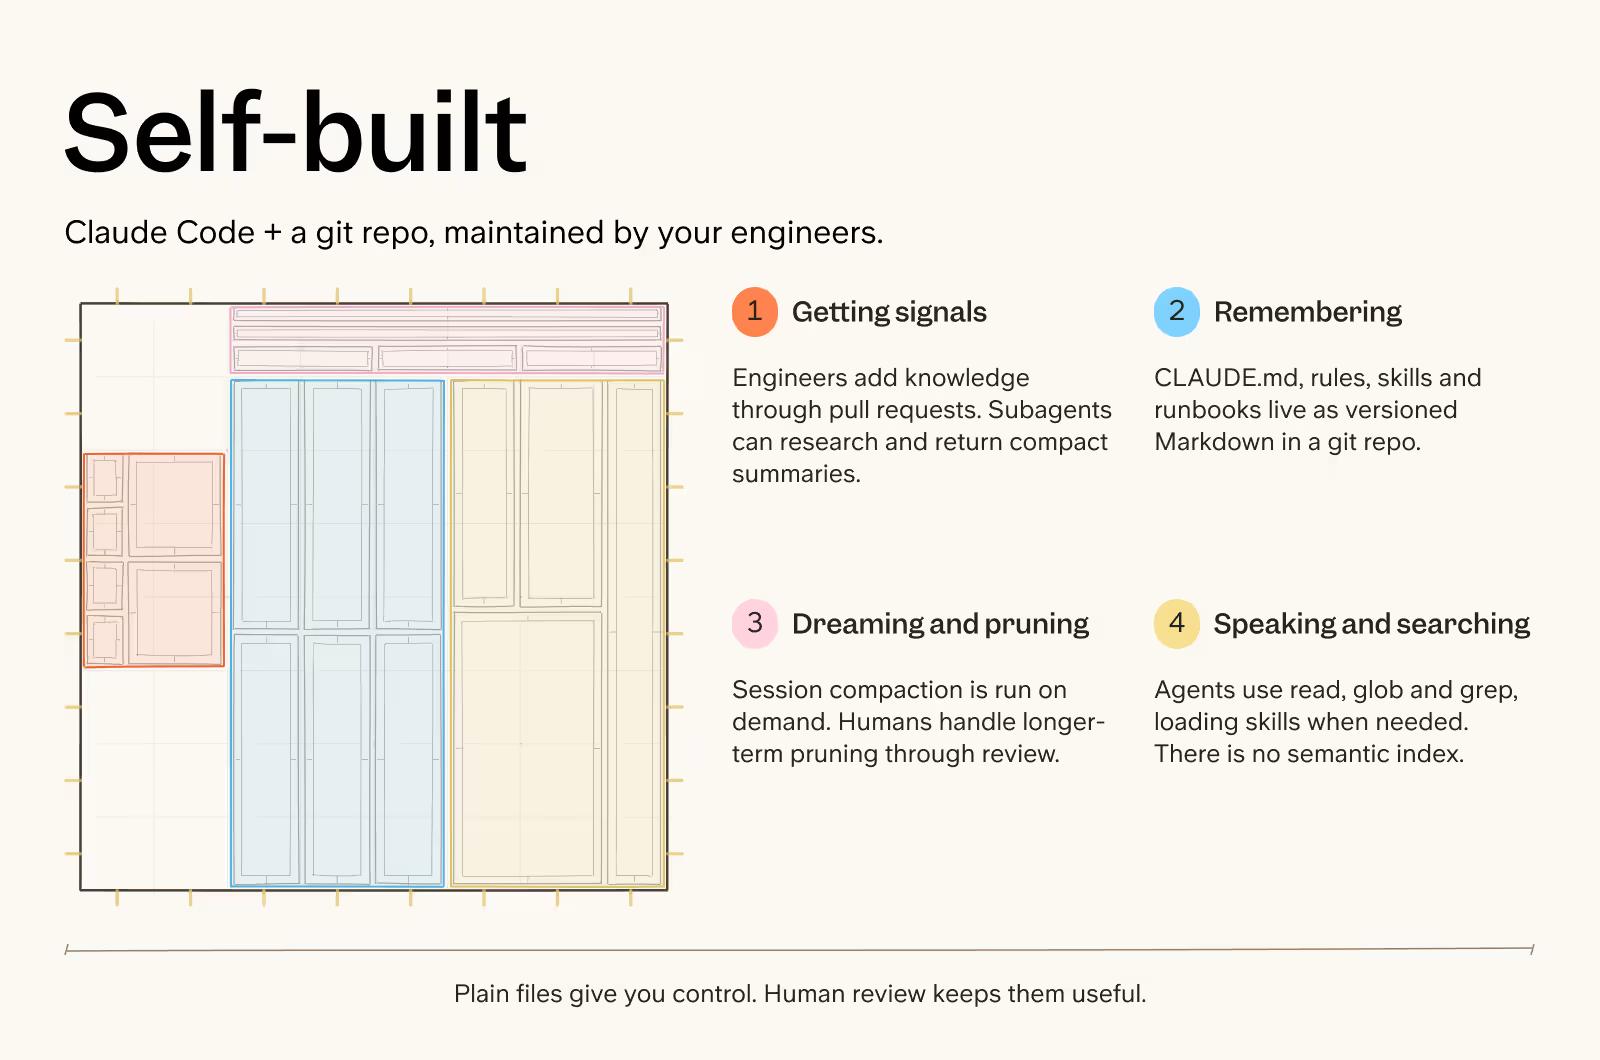
C'est le modèle par lequel a commencé la moitié de nos répondants qui ont essayé un company brain : un agent de code relié à un dépôt de Markdown, des pull requests et une recherche dans des fichiers simples. Pas de produit, pas d'éditeur, et un ingénieur qui le maintient en bonne santé.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Les ingénieurs ajoutent et mettent à jour les connaissances via des pull requests. Des sous-agents peuvent faire des recherches en parallèle, puis renvoyer des résumés compacts que l'agent parent enregistre. |
| Mémoriser | La mémoire vit dans le dépôt git : CLAUDE.md, règles, skills, runbooks et autres fichiers Markdown, tous versionnés avec le reste du système. |
| Rêver et élaguer | La compaction de session est une commande que vous lancez quand le contexte devient trop chargé. L'élagage à plus long terme passe par la relecture humaine, généralement dans les pull requests. |
| Parler et chercher | Les agents utilisent read, glob et grep pour trouver du contexte dans les fichiers simples, en ne chargeant les skills qu'au besoin. Il n'y a pas d'index sémantique. |
Coût et adéquation. Gratuit, hors utilisation des modèles. Idéal pour les équipes pilotées par les ingénieurs de moins de 50 personnes qui veulent un contrôle total et acceptent que la curation soit une corvée permanente. Pour les workflows que cela permet, voir pourquoi Claude Code a besoin d'un company brain.
2. GBrain
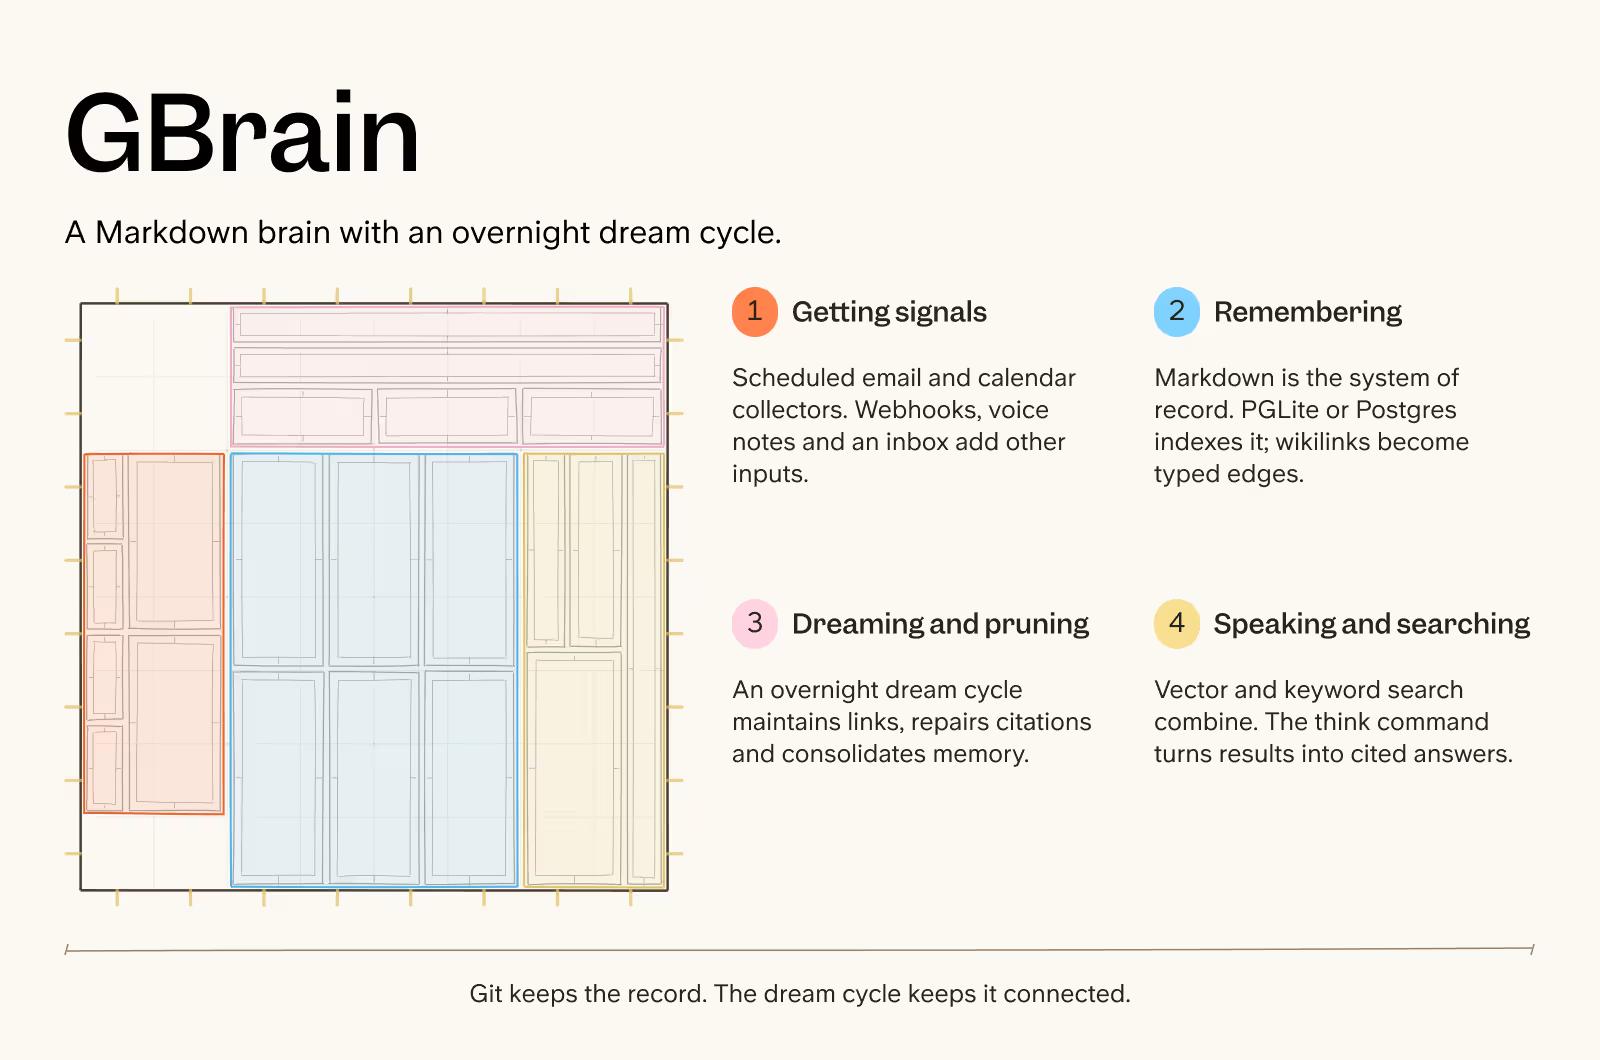
GBrain est le brain personnel open source que Garry Tan a publié en avril 2026, et le projet qui a fait de la Request for Startups de YC une catégorie. Git conserve la trace durable. Un cycle de rêve planifié entretient le graphe et consolide la mémoire pendant la nuit.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Les e-mails et le calendrier arrivent via des collecteurs planifiés. Des webhooks généraux, des notes vocales, un dossier de réception et des skillpacks personnalisés offrent d'autres moyens d'alimenter le brain. |
| Mémoriser | Votre dépôt Markdown reste le système de référence. GBrain l'indexe avec PGLite par défaut, ou Postgres avec pgvector pour les déploiements partagés, et transforme les wikilinks locaux en arêtes typées sans LLM. |
| Rêver et élaguer | Planifiez le cycle de rêve pour la nuit et GBrain entretient les liens, répare les citations et consolide la mémoire. Sa commande « think » signale aussi le contexte périmé, les affirmations sans source et les contradictions. |
| Parler et chercher | La recherche mêle récupération vectorielle et par mots-clés avec fusion des rangs. Trois modes de recherche arbitrent entre coût et qualité, et « think » transforme les résultats en une réponse citée. |
Coût et adéquation. Gratuit à exploiter, hors vos propres coûts d'embedding et de modèle. Conçu d'abord pour le contexte d'une seule personne ; il fonctionne comme company brain pour une petite équipe technique à l'aise dans un terminal. Si vous cherchez des alternatives à GBrain, les plus proches sont Sylph ci-dessous pour un dépôt partagé, et mem0 ou Zep pour une couche de mémoire sous vos propres agents. Nous l'avons étudié en détail dans notre test de GBrain.
3. Sylph
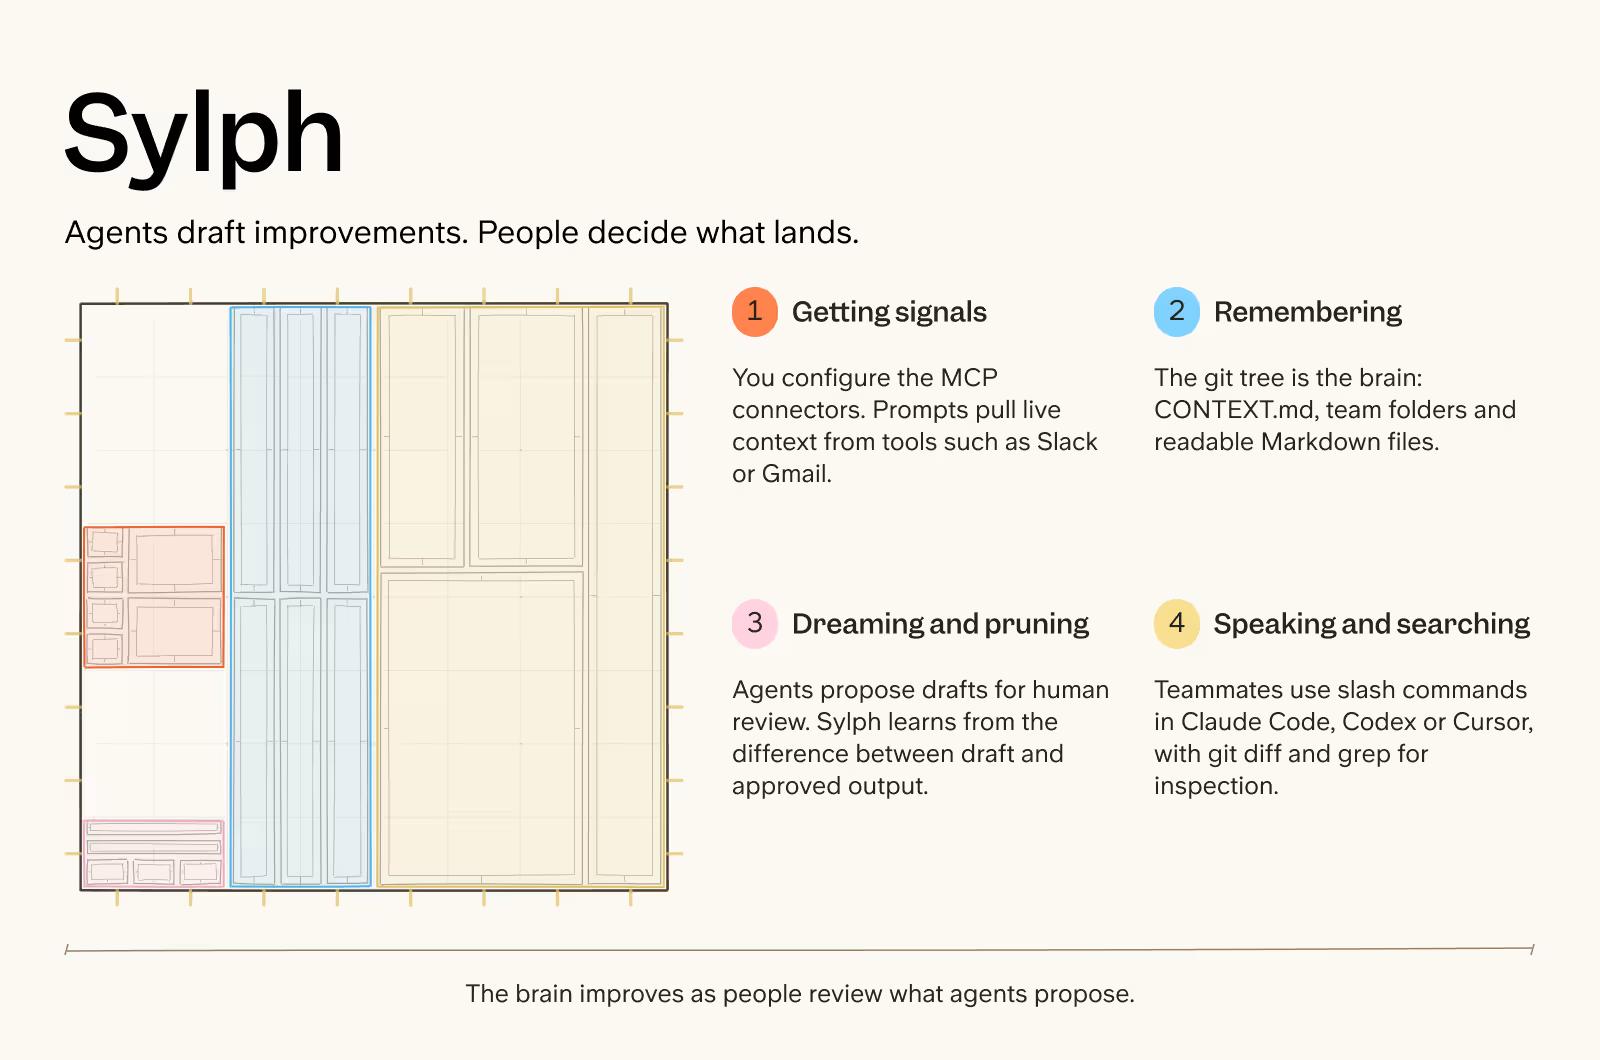
Sylph, de nao Labs, garde le company brain dans un dépôt git que vous pouvez lire et façonner vous-même. Les agents peuvent proposer des améliorations, mais ce sont les personnes qui décident de ce qui est retenu.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Sylph n'intègre aucune source de données externe. Vous choisissez et configurez les connecteurs MCP qu'il peut utiliser, de sorte que les prompts puissent récupérer du contexte en direct depuis des outils comme Slack ou Gmail. |
| Mémoriser | Le brain, c'est l'arborescence git elle-même : un CONTEXT.md central, des dossiers par domaine pour des équipes comme la marque, les ventes, le produit, les RH et le juridique, et des fichiers Markdown que les agents peuvent lire. |
| Rêver et élaguer | Les agents placent les améliorations proposées dans un dossier de brouillons pour relecture humaine. Dès qu'une personne approuve un résultat, Sylph compare le brouillon avec ce qui a été retenu et met à jour ses propres règles à partir de la différence. |
| Parler et chercher | Les collègues travaillent via des commandes slash dans Claude Code, Codex ou Cursor. Comme la mémoire est du Markdown simple dans git, chacun peut inspecter les changements avec des outils familiers comme git diff et grep. |
Coût et adéquation. Gratuit et open source. Une équipe de la taille d'une startup qui fait déjà tourner ses opérations avec des agents de code s'y sentira à l'aise. Le revers : rien n'est automatisé, le brain ne s'améliore qu'à la vitesse à laquelle un humain relit les brouillons.
SDK de mémoire
4. mem0
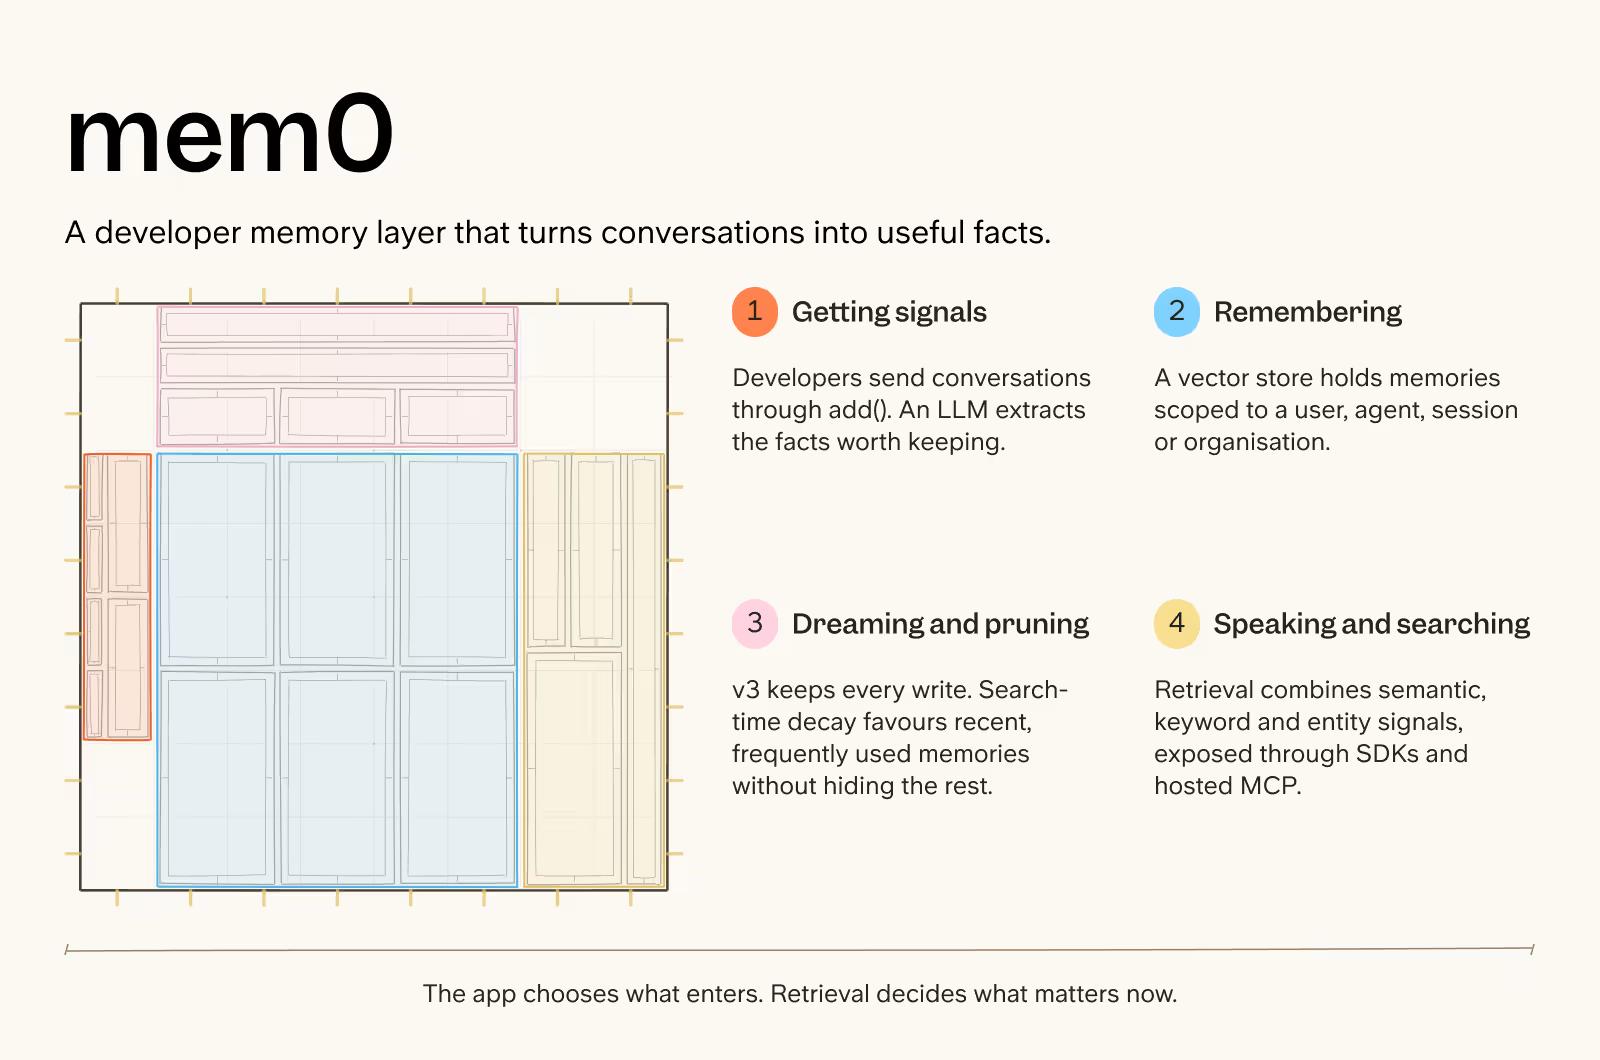
mem0 est une couche de mémoire pour développeurs qui transforme les conversations en faits utiles, puis ressort les bons quand une application en a besoin. C'est l'option la plus largement adoptée de cette famille, avec une plateforme hébergée au-dessus du noyau open source.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Les développeurs choisissent quand envoyer une conversation via un appel add(). mem0 utilise un LLM pour extraire les faits qui valent la peine d'être gardés, si bien que l'ingestion démarre à l'intérieur de l'application plutôt que selon un planning. |
| Mémoriser | Les souvenirs vivent dans un magasin vectoriel et peuvent être rattachés à un utilisateur, un agent, une session ou une organisation. L'extraction d'entités est fournie dans la version open source, tandis que le graphe interactif se trouve sur la plateforme hébergée. |
| Rêver et élaguer | La v3 conserve chaque écriture au lieu de mettre à jour ou de supprimer les anciens souvenirs. Au moment de la recherche, une décroissance de la mémoire favorise légèrement les souvenirs récents et fréquemment utilisés sans cacher les autres. |
| Parler et chercher | Quand l'application demande du contexte, mem0 combine la recherche sémantique avec des signaux de mots-clés et d'entités. Les développeurs peuvent utiliser ses SDK ou se connecter via le serveur MCP hébergé. |
Coût et adéquation. La version open source est gratuite. La plateforme hébergée propose une offre gratuite et des forfaits à l'usage. À choisir si vous construisez vos propres agents et voulez une mémoire qui fonctionne simplement, en acceptant d'assembler vous-même tout ce qui se trouve au-dessus de la couche de mémoire.
5. Zep / Graphiti
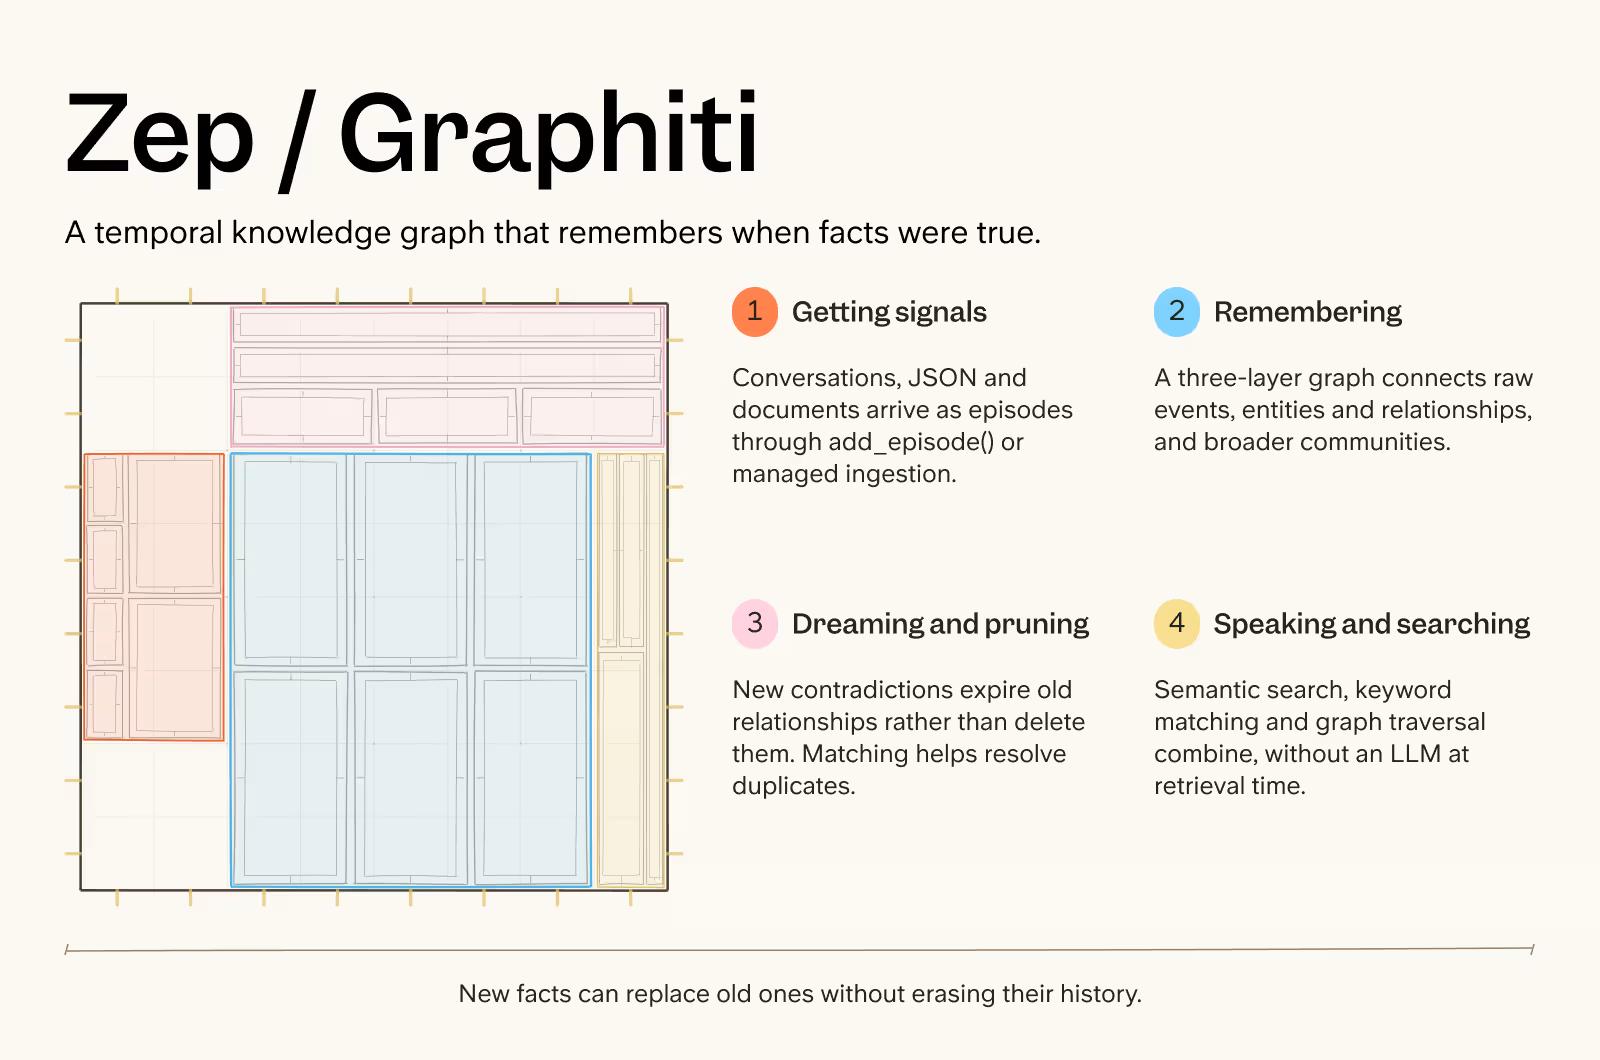
Zep tient un graphe temporel de personnes, d'événements et de faits, et marque les anciennes informations comme expirées quand quelque chose de plus récent les rend obsolètes. Graphiti est le moteur de graphe open source qui se trouve en dessous.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Les conversations, le JSON et les documents arrivent sous forme d'épisodes via un appel add_episode() ou le pipeline d'ingestion géré de Zep. |
| Mémoriser | Chaque épisode alimente un graphe de connaissances à trois couches : les événements bruts, les entités et relations extraites, et des communautés plus larges. Les faits sont vectorisés et horodatés, si bien que le graphe retient à la fois ce qui s'est passé et quand c'était vrai. |
| Rêver et élaguer | Quand une nouvelle information contredit un fait plus ancien, un LLM marque l'ancienne relation comme expirée au lieu de la supprimer. Un appariement approximatif contrôlé par l'entropie aide à résoudre les doublons probables sans fusionner des noms ambigus. |
| Parler et chercher | Au moment de la requête, Zep combine recherche sémantique, correspondance de mots-clés et parcours du graphe. Comme la récupération n'a pas besoin d'un LLM, les résultats reviennent en bien moins d'une seconde. |
Coût et adéquation. Graphiti est gratuit. Le cloud de Zep est freemium, avec des offres entreprise. Le bon choix quand vos questions portent sur l'historique (« qu'est-ce qui était vrai en mars ? ») et que vous avez des ingénieurs pour régler la récupération.
6. Letta
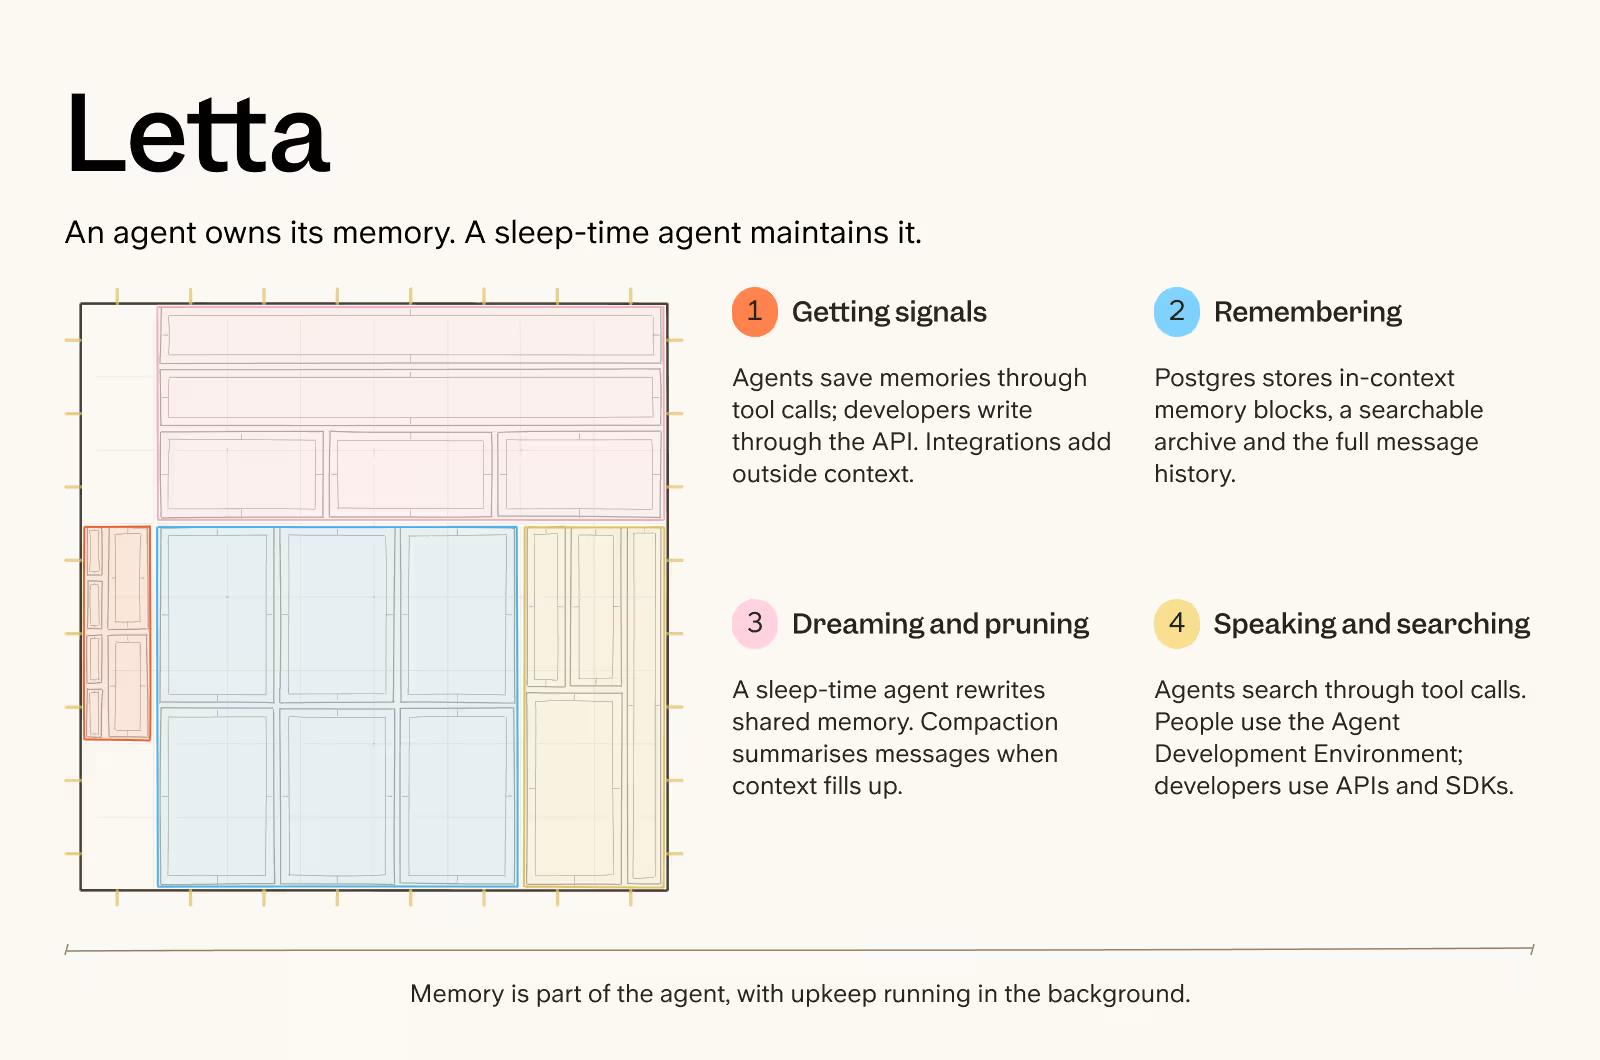
Letta laisse l'agent décider de ce qui mérite d'entrer en mémoire, tandis qu'un agent de veille travaille en arrière-plan sur le contexte partagé. Il est issu de l'article de recherche MemGPT et c'est l'option la plus solide sur le plan académique de cette liste.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | L'agent peut enregistrer et mettre à jour des souvenirs via ses propres appels d'outils, tandis que les développeurs peuvent écrire via l'API. Des intégrations natives avec Slack, Telegram et GitHub peuvent apporter du contexte externe. |
| Mémoriser | La mémoire est répartie en trois couches : de petits blocs étiquetés gardés dans le contexte, une archive consultable en dehors de la fenêtre de contexte, et l'historique complet des messages. Letta les stocke dans Postgres. |
| Rêver et élaguer | Un agent de veille réécrit la mémoire partagée en arrière-plan. Quand le contexte se remplit, la compaction résume environ 30 % des messages et garde le reste. |
| Parler et chercher | L'agent cherche dans la mémoire et la met à jour via des appels d'outils. Les personnes peuvent l'inspecter et la modifier dans l'Agent Development Environment, tandis que les développeurs passent par des API REST et des SDK. |
Coût et adéquation. La version open source est gratuite ; Letta Cloud est facturé à l'usage. Idéal pour les équipes qui livrent des agents avec état et veulent que ce soit l'agent, et non un pipeline, qui possède sa mémoire.
Brains verticaux et internes
7. Pletor
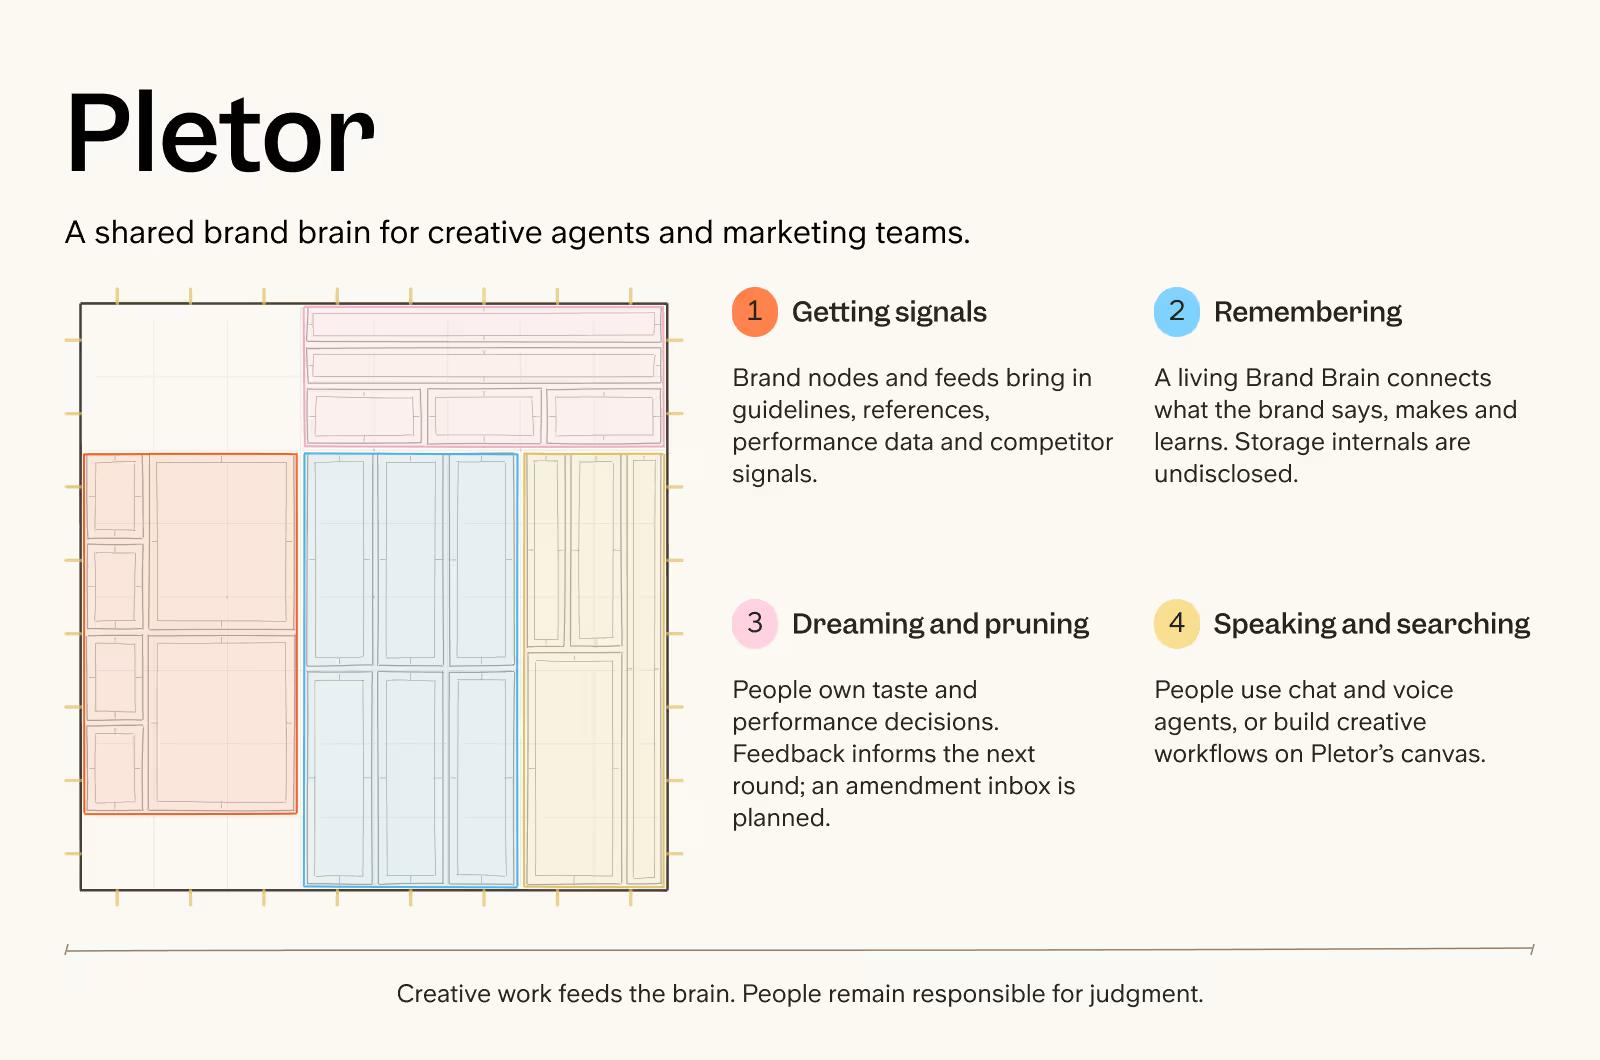
Pletor transforme les règles de marque, les références créatives et les données de performance en une mémoire partagée que ses agents créatifs peuvent utiliser. C'est un brain de marque pour les équipes marketing plutôt qu'un company brain pour toute l'entreprise, et il figure dans cette liste parce qu'il montre à quoi ressemble ce modèle quand il est limité à une seule fonction.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Des nœuds de marque et des flux de données apportent les guides de style, les références, les données de performance et les signaux sur la concurrence. Le système fonctionne avec le texte, les images, la vidéo et l'audio. |
| Mémoriser | Pletor conserve ces éléments dans un seul Brand Brain vivant, qui relie ce que dit la marque, ce qu'elle produit et ce qu'elle apprend de la performance. Les détails du stockage ne sont pas divulgués. |
| Rêver et élaguer | Les personnes restent responsables des décisions de goût et de performance, tandis que les retours et les résultats alimentent le prochain cycle de travail créatif. Une boîte de réception pour les amendements du brain, déduits de vos conversations, est prévue dans la feuille de route. |
| Parler et chercher | Les personnes travaillent avec le brain via le chat et des agents vocaux, ou construisent des workflows créatifs sur le canevas de Pletor. |
Coût et adéquation. Freemium avec des forfaits équipe payants. Convient aux équipes marketing qui veulent que leurs agents respectent la marque par défaut. Ses fondateurs ont aussi été les plus francs parmi les personnes interviewées sur les limites de l'autonomie : « L'idée d'avoir un Claude ouvert qui apprend de votre Slack et fait tourner les choses tout seul est séduisante. Mais c'est assez difficile à mettre en œuvre. »
8. Gorgias Cortex
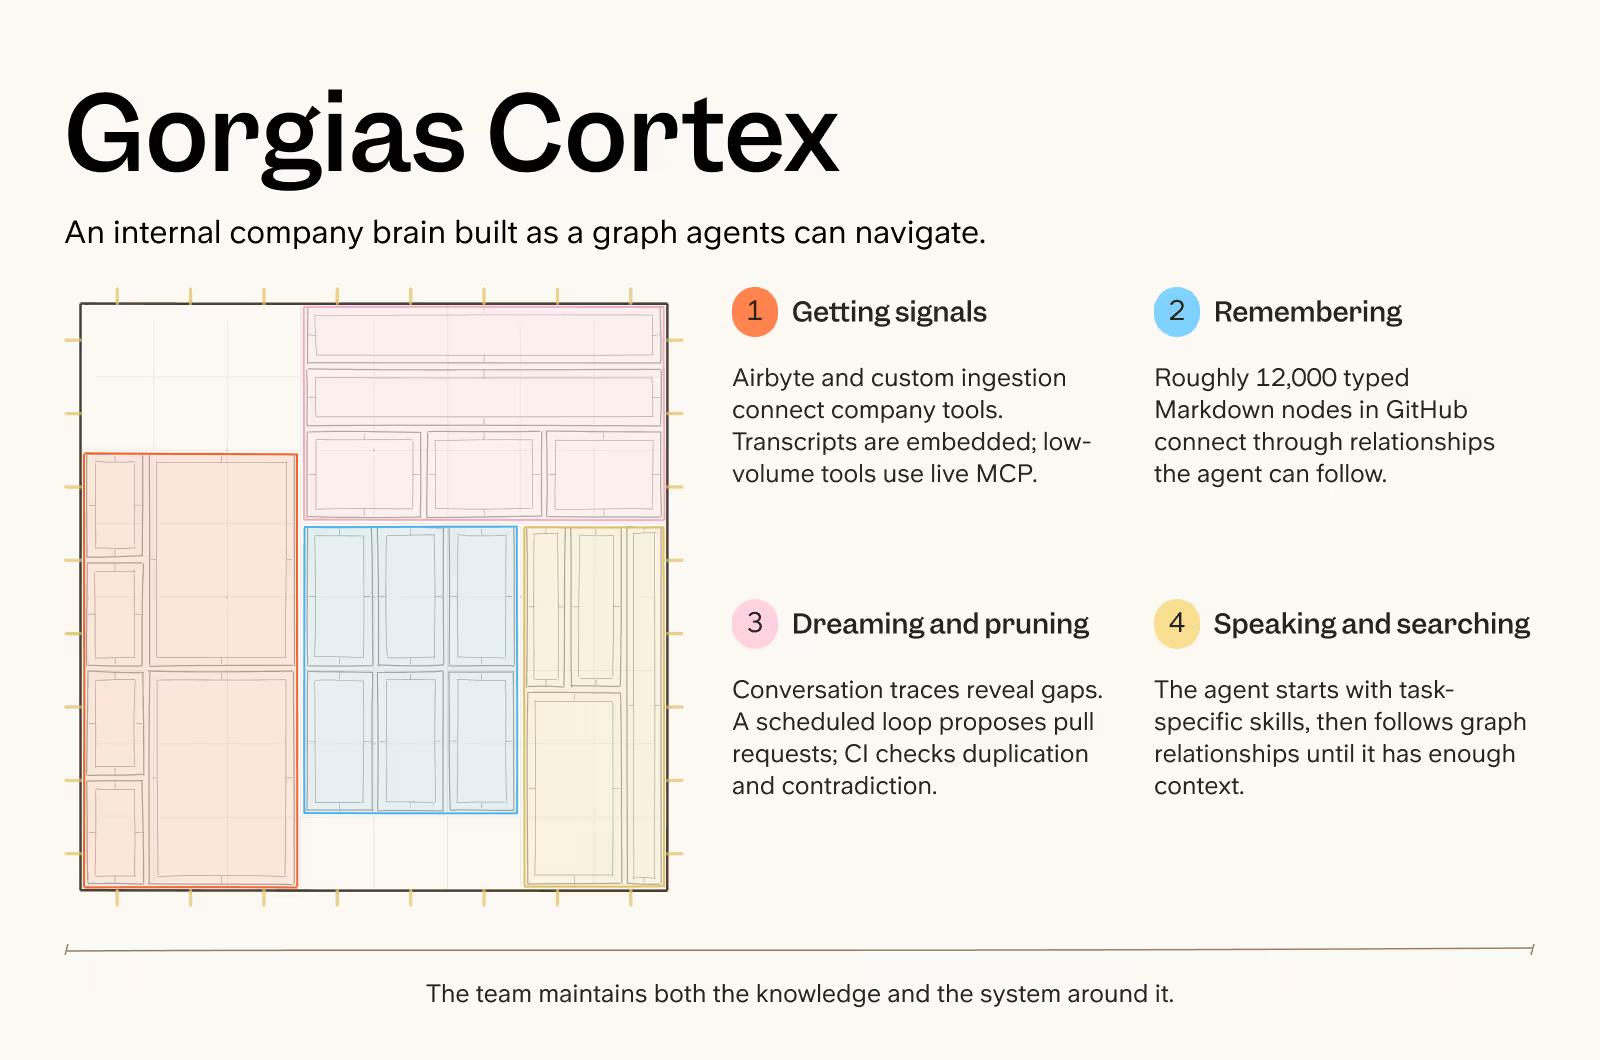
Gorgias a construit Cortex à partir des systèmes que ses équipes utilisent déjà, en transformant la connaissance de l'entreprise en un graphe que ses agents peuvent parcourir. C'est un projet interne, pas un produit, et le company brain construit en interne le plus abouti que nous ayons étudié.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Airbyte et un outil d'ingestion sur mesure apportent Postgres, Notion, Gong, GitHub, Linear et HubSpot. Les longues transcriptions sont découpées et vectorisées pour rester consultables ; les outils à faible volume sont interrogés en direct via MCP. |
| Mémoriser | Le résultat est un graphe de connaissances d'environ 12 000 nœuds Markdown typés dans GitHub, reliés par des relations que l'agent peut suivre. |
| Rêver et élaguer | L'équipe étudie les traces de conversation pour repérer le contexte manquant. Une boucle de maintenance planifiée regroupe les lacunes récurrentes en pull requests qui améliorent le graphe, et des contrôles CI détectent les doublons et les contradictions avant la fusion. |
| Parler et chercher | L'agent démarre avec des skills propres à la tâche, puis suit les relations dans le graphe jusqu'à avoir assez de contexte pour répondre. Une requête typique coûte de 10 à 30 centimes. |
Coût et adéquation. Pas à vendre, et c'est justement la leçon. Gorgias peut assumer les deux tâches qu'exige un brain construit en interne, curer le contenu et repenser l'architecture à mesure que le domaine évolue, parce qu'il dispose d'une équipe IA interne de huit personnes. La plupart des entreprises n'en ont pas.
Company brains dédiés
9. Carrara
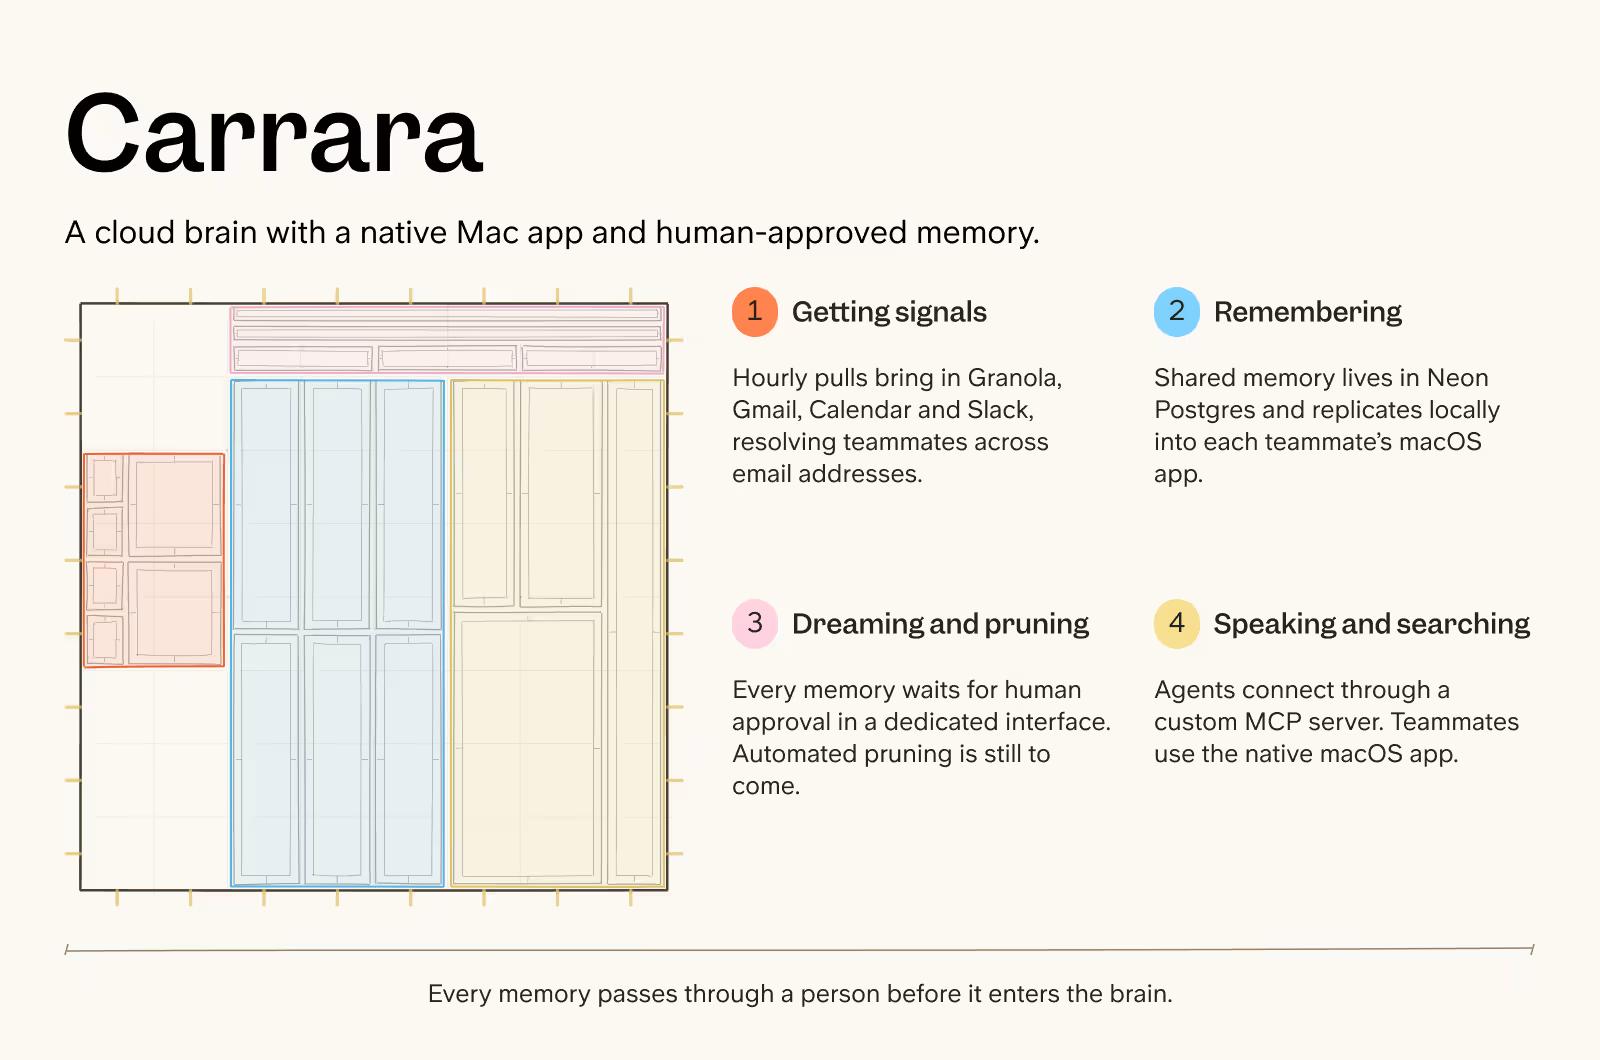
Carrara est un brain dans le cloud répliqué dans une application Mac native, où chaque souvenir est approuvé par une personne avant d'entrer dans le brain.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Toutes les heures, Carrara puise dans Granola, Gmail, Calendar et Slack, en reconnaissant chaque collègue à travers plusieurs adresses e-mail. Composio facilite l'ajout de nouvelles sources. |
| Mémoriser | La mémoire partagée vit dans Neon Postgres, tandis qu'une application macOS native la réplique en local pour chaque collègue. |
| Rêver et élaguer | Rien n'entre dans le brain sans relecture. Une interface d'acceptation dédiée garde chaque souvenir approuvé par un humain. L'élagage automatique reste à venir. |
| Parler et chercher | Les agents se connectent via un serveur MCP sur mesure, tandis que les collègues utilisent l'application macOS native. |
Coût et adéquation. Au stade précoce ; tarifs non publics. Le pari intéressant, c'est la conception axée sur la relecture : elle accepte une croissance plus lente du brain en échange de ne jamais stocker quelque chose qu'un humain n'a pas vu.
10. Slite Agent
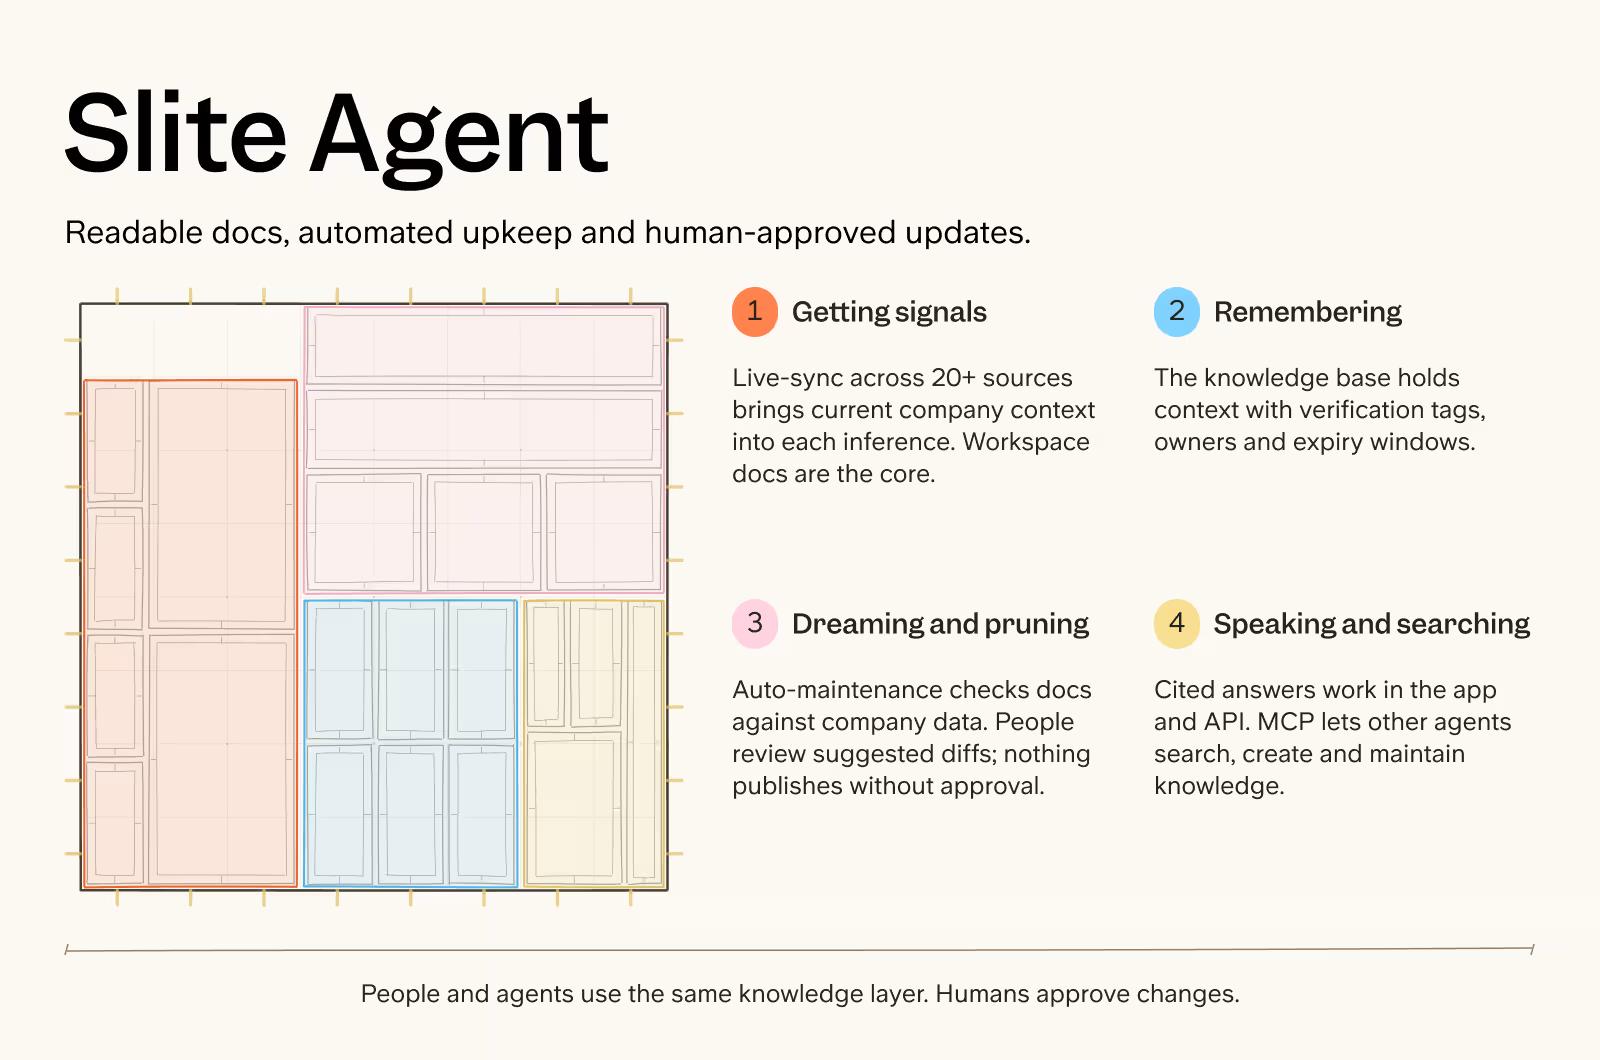
Slite conserve les docs que les gens utilisent déjà, puis ajoute autour d'eux la relecture, l'expiration, la maintenance et des réponses citées. C'est notre propre produit : lisez donc cette entrée comme les choix de conception que nous avons faits, et non comme un verdict.
| Composant | Ce qu'il utilise |
|---|---|
| Capter les signaux | Slite Agent se synchronise en direct avec plus de 20 sources, Slack, Drive, Notion, GitHub, Jira et d'autres, afin d'apporter le contexte d'entreprise le plus récent à chaque inférence. Les docs et les pièces jointes de l'espace de travail en constituent le cœur. |
| Mémoriser | Les personnes et les agents envoient du contexte dans la base de connaissances de Slite avec des tags de vérification, des responsables et des fenêtres d'expiration qui rendent son statut clair. Les docs restent le stockage. |
| Rêver et élaguer | Avec la maintenance automatique, Slite vérifie régulièrement vos docs par rapport au reste des données de votre entreprise. Les mises à jour suggérées apparaissent sous forme de différences côte à côte dans une vue de tri, où vous décidez de ce qui change. Rien n'est publié sans approbation. |
| Parler et chercher | Slite Agent répond avec des citations dans l'application et l'API, et déclasse les sources non vérifiées. Son serveur MCP permet aussi à d'autres agents de chercher, créer et maintenir des connaissances. |
Coût et adéquation. Abonnement par utilisateur. Conçu pour les équipes de 50 à 500 personnes qui veulent un company brain qui se maintient tout seul et reste lisible par les humains, sans que le contexte finisse dans une plateforme qu'elles ne peuvent pas quitter.
Ce sur quoi s'accordent les personnes qui construisent des company brains
Les entreprises ci-dessus divergent sur presque tout : la stratégie de récupération, graphe ou pas de graphe, le niveau d'automatisation. Parmi les outils étudiés, nous avons trouvé cinq rerankers différents, trois philosophies de recherche et aucun benchmark commun.
Mais sur quatre points, toutes les personnes interviewées sont arrivées au même endroit.
- Vous maintiendrez le company brain pour toujours. Chez Slite, des entreprises qui ont déjà essayé de construire un company brain en interne nous contactent régulièrement, et le plus difficile, c'est toujours la maintenance. Un brain construit en interne, ce sont en réalité deux tâches : curer le contenu, et repenser l'architecture du système à mesure que le domaine évolue. Gorgias peut assumer les deux, mais pour la plupart des équipes, la seconde est celle que personne ne budgète.
- L'IA n'est pas prête à écrire sans supervision dans la connaissance de votre entreprise. La connaissance créée automatiquement fonctionne dans les brains personnels, parce que vous n'avez aucun conflit avec vous-même. Le contexte d'entreprise est différent : les agents peinent à distinguer un plan défini d'une longue conversation Slack, présumée faire autorité, sur un changement potentiel. C'est pourquoi toutes les entreprises qui proposent une solution de company brain adoptent par défaut un tri humain : Pletor construit une boîte de réception pour les amendements, Gorgias fait passer chaque correction du graphe par une pull request relue, les agents de Sylph ne peuvent pas promouvoir leurs propres brouillons, Carrara approuve chaque souvenir, et nous avons intégré Agent Triage à Slite avant de livrer l'Agent.
- La capture doit se faire là où le travail se fait. Même les utilisateurs les plus engagés d'une base de connaissances nous ont dit qu'ils n'arrivaient pas à continuer de l'alimenter. « Il faut être très volontaire pour nourrir la machine, et même avec les meilleures intentions de ma part pour faire tourner ce truc, je ne le faisais pas non plus », a déclaré Glen Sykes, Chief Product Officer chez Spoor. La capture se déplace donc dans le travail lui-même : Gorgias exploite ses propres traces de conversation, Pletor déduit les amendements des conversations, et Slite Agent surveille l'activité dans les outils connectés au lieu d'attendre que quelqu'un écrive les choses.
- Les gens continueront à poser des questions au brain. Les agents en poseront davantage. mem0, Guru et Slite ont tous lancé des serveurs MCP cette année, et Gorgias en expose un pour les équipes qui privilégient le code. Dès qu'une entreprise fait tourner de vrais workflows d'agents, les requêtes des agents dépassent celles des humains de plusieurs ordres de grandeur.
De quel company brain avez-vous besoin ?
Trois questions décident l'essentiel : quelle est la taille de votre équipe, ce qui vous inquiète le plus, et qui serait responsable du brain en interne.
| Si | Choisissez | Pourquoi |
|---|---|---|
| Des ingénieurs que cela amuserait, 50 personnes ou moins, et le coût est la crainte | Auto-hébergé (GBrain, Sylph, construit en interne) | Vous avez les ingénieurs et l'envie. Construisez-le, possédez-le, payez presque rien. |
| Des ingénieurs, 50 personnes ou moins, et les mauvaises réponses sont la crainte | SDK de mémoire (mem0, Zep, Letta) plus votre propre réglage de la récupération | Si la précision vous empêche de dormir, vous voudrez garder la main sur la pile de récupération. |
| Des ingénieurs, mais plus de 50 personnes | Company brains dédiés | Votre équipe peut le construire, mais à cette taille personne n'a la disponibilité de le maintenir en plus. |
| L'effort de mise en place est la crainte | Company brains dédiés | Les brains dédiés sont devenus rapides à déployer, et vous serez toujours propriétaire de votre contexte dans un an. |
| Le garder en vie est la crainte | Company brains dédiés | La maintenance est ce qui vous inquiète. Choisissez la catégorie qui l'automatise. |
| Qui voit quoi est la crainte | Company brains dédiés | Les permissions doivent être intégrées à la couche, pas héritées d'une plateforme que vous ne pouvez pas quitter. |
| Personne de technique, il faut que ça marche tout simplement | Company brains dédiés | Personne ne va se battre avec des fichiers YAML. Il vous faut quelque chose qui marche dès le jour de l'inscription. |
| Quelques profils techniques, pas de disponibilité, et le coût est la crainte | Auto-hébergé avec une empreinte légère (GBrain, Sylph) | Une mise en place légère, des fichiers simples, un coût d'exploitation quasi nul, sans que cela devienne le travail à plein temps de quelqu'un. |
Quel que soit votre choix, considérez la souveraineté du contexte comme une exigence. Le company brain doit être sa propre couche. Il se place au-dessus des plateformes et des modèles, et ne doit loyauté à aucun des deux.
Construire ou acheter : cinq questions d'architecture à trancher d'abord
Avant de vous engager à construire, il y a cinq décisions d'architecture que toute équipe prend, qu'elle construise ou qu'elle achète.
Où vivent les souvenirs du brain : une base de données ou des fichiers ?
Le choix du stockage est la décision la moins différenciante de la pile. Les équipes qui ont construit leur propre brain l'ont fait tourner sur du Markdown simple dans un dépôt git, sur du stockage objet et sur Postgres, et sont passées de l'un à l'autre sans toucher à la structure de la connaissance.
Postgres revient souvent comme solution : c'est un système de fichiers, à condition que chaque entrée porte un titre, une description et un responsable.
Ce avec quoi vous vivrez, c'est la forme de la mémoire et la couche de contexte qui la sert aux personnes et aux agents.
Si vous construisez, choisissez ce que votre équipe sait exploiter. Si vous achetez, demandez si votre contexte est exportable en fichiers simples, car c'est ce qui garde le brain à vous.
Des enregistrements structurés ou un graphe de connaissances, et où se trouve la source de vérité ?
La séparation tient à la question de savoir qui possède le fait.
Les entités qui appartiennent aux systèmes, comme les clients, les tables et les métriques, restent dans le système qui les produit, et le brain y renvoie au lieu de les copier.
La connaissance qui appartient aux personnes, comme les décisions, les processus et les définitions, relève de documents maintenus avec un statut défini par un humain.
Cette base de connaissances maintenue est la source de vérité, et la récupération lit les deux au moment de la requête.
Ce dont vous n'avez pas besoin, c'est d'un graphe stocké comme troisième source de vérité. Il devient obsolète à chaque réorganisation, ce qui explique pourquoi nous soutenons que vous n'avez pas besoin d'un graphe de contexte.
Les bâtisseurs que nous avons interviewés ne sont pas non plus d'accord sur les graphes : certains ont misé toute leur architecture sur des graphes temporels, certains en ont construit un à la main, certains n'en livrent aucun.
Qui peut voir quoi ?
Dès que toute l'équipe et ses agents puisent dans le même brain, il faut décider qui voit quels documents. Les personnes ont toujours pu ouvrir des fichiers qu'elles n'étaient pas censées voir, mais un agent cherche dans tout ce qu'il peut atteindre.
Le modèle qui fonctionne consiste à exposer le brain via une interface unique, typiquement un serveur MCP, et à donner à chaque agent un niveau d'accès, afin qu'un agent en contact avec les clients ne touche jamais aux données financières.
Construisez si vous pouvez cartographier vous-même les permissions sur toutes les sources. Achetez si vous avez besoin qu'elles se transmettent depuis les outils que vous utilisez déjà.
Les permissions étaient la deuxième préoccupation de notre enquête, à 63 %, et notre guide sur le contrôle d'accès des agents IA couvre ces modèles en détail.
Qui le garde fidèle à la réalité ?
Un company brain sans responsable ressemble au frigo du bureau. Tout le monde y met des choses, personne ne se sent chargé de jeter ce qui a tourné, et au bout de quelques mois on ne fait plus confiance à rien de ce qu'il contient.
Tous les brains qui fonctionnent aujourd'hui arrivent à la même réponse : l'IA propose, un responsable nommé approuve, comme une pull request pour la connaissance.
Quand deux modifications s'opposent, le responsable du document décide de ce qui entre.
Dans Slite, cela se règle au niveau de la maintenance, avec un responsable par document et une couche de commentaires pour désigner des relecteurs précis.
Construisez si vous êtes prêt à faire tourner ce flux de relecture longtemps après le lancement. Achetez si personne n'a ce temps.
Le workflow complet, de la responsabilité aux files de relecture, se trouve dans notre guide sur la maintenance d'une base de connaissances.
Où construire cesse-t-il d'avoir du sens ?
Une équipe de quatre peut construire un brain fonctionnel en environ quatre semaines, mais généralement après un an passé à comprendre ce qu'elle veut, et avec des ingénieurs qui ont déjà livré des systèmes agentiques.
La démo qui fonctionne est la partie facile.
Construire, ce sont deux tâches :
- curer le contenu,
- et repenser l'architecture du système à mesure que le domaine évolue.
Concrètement, un brain construit en interne qui dure demande 500 personnes ou plus et quelques ingénieurs qui s'y consacrent indéfiniment.
En dessous, la ligne « auto-hébergé » du tableau ci-dessus désigne une installation légère à base de fichiers simples, et non un produit que votre équipe passe son temps à repenser.
Pour les plus petites équipes, même celles où tout le monde connaît git et Claude, construire soi-même est disproportionné.
Quand une base de connaissances est le company brain
Il y a une question à laquelle aucun des articles sur les company brains ne répond : le brain se place-t-il au-dessus de votre base de connaissances, ou la base de connaissances peut-elle être le brain ?
Chaque éditeur revendique sa propre couche. Notre réponse, et la raison pour laquelle nous avons construit Slite Agent comme nous l'avons fait, c'est que pour la plupart des équipes les docs auxquels les gens font déjà confiance sont le bon stockage, à condition que trois choses soient vraies.
Chaque doc porte un statut défini par un humain : vérifié, obsolète, expirant.
Quelque chose confronte ces docs à la réalité et propose des corrections, sans les publier de lui-même. Et les agents peuvent atteindre la même couche vérifiée que les personnes, via MCP, avec les mêmes permissions.
Vous obtenez ainsi la maintenance automatisée de la famille dédiée, la lisibilité de simples docs, et aucun des verrouillages des acteurs établis intégrés.
Si cela ressemble au brain dont votre équipe a besoin, réservez une démo ou commencez avec Slite Agent. Et si vous voulez les entretiens complets derrière cet article, ils sont dans Company Brain 101.
FAQ
Glean est-il un company brain ?
Glean est un moteur de recherche d'entreprise avec une couche d'IA : il trouve et résume ce qui existe déjà dans vos outils. Il ne maintient ni ne corrige cette connaissance, et il garde votre contexte à l'intérieur de sa plateforme. C'est donc un acteur établi intégré plutôt qu'une couche de company brain indépendante. Voir notre test de Glean.
Existe-t-il des company brains open source ?
Oui. GBrain et Sylph stockent le brain sous forme de fichiers simples dans git. mem0, Graphiti (Zep) et Letta sont des couches de mémoire open source que vous pouvez auto-héberger. Tous laissent la maintenance à votre équipe.
Comment un company brain reste-t-il à jour ?
Grâce au composant « rêver et élaguer » : passes de consolidation, décroissance dans le temps, détection des écarts par rapport aux outils en direct, et files de relecture humaine. Les outils de cette liste diffèrent surtout sur ce point, et c'est le composant qui décide si le brain devient le wiki périmé qu'il remplaçait.
Combien coûte un logiciel de company brain ?
Les options auto-hébergées sont gratuites hors coûts de modèle et d'hébergement, mais la maintenance retombe sur votre équipe ; dans notre enquête, 27 % des équipes ont abandonné un brain construit en interne pour cette raison. Les SDK de mémoire sont facturés à l'usage. Les company brains dédiés sont des abonnements par utilisateur.
Notion suffit-il pour un second cerveau ?
Pour un second cerveau personnel, souvent oui. Pour un company brain, Notion couvre le composant « mémoriser » et pas grand-chose d'autre : rien ne confronte les pages à la réalité, et la recherche comme les permissions restent à l'intérieur de la plateforme. C'est le compromis des acteurs établis intégrés décrit plus haut.
Un company brain peut-il tourner on-prem ?
Les modèles auto-hébergés (GBrain, Sylph, un brain construit en interne comme celui de Gorgias) et les SDK de mémoire open source le peuvent. Les company brains dédiés sont pour la plupart des produits cloud : demandez donc à chaque éditeur ce qu'il en est de la résidence des données et si votre contexte est exportable en fichiers simples.
Faut-il un graphe de connaissances pour construire un company brain ?
Non. Certains outils de cette liste en utilisent un, comme Graphiti de Zep et le brain de Gorgias, tandis que GBrain et Sylph utilisent des fichiers simples. Un graphe stocké est un choix de récupération, pas une exigence, et il demande un jardinage constant à mesure que l'entreprise change. Une récupération agentique sur une base de connaissances maintenue donne les mêmes réponses multi-sauts sans cet entretien.