Ein Company Brain nimmt alles, was Ihr Unternehmen weiß, also das, was in Dokumenten, in den Köpfen der Mitarbeitenden und verstreut über verschiedene Tools steckt, und macht es als Antworten oder Kontext nutzbar. Für Menschen und Agenten gleichermaßen.
Wenn Ihnen der Begriff neu ist, beginnen Sie mit unserer ausführlichen Definition und der Entstehungsgeschichte und kehren Sie danach hierher zurück.
Die Kategorie der Company-Brain-Lösungen ist erst rund sechs Monate alt, und inzwischen wollen Dutzende Unternehmen das Company Brain sein.
Manche sind Open-Source-Repos mit ein paar hundert Sternen. Manche sind Memory-Bibliotheken für Entwickler. Manche sind interne Projekte, die nie zum Verkauf gedacht waren. Und einige wenige sind dedizierte Produkte.
Alle beantworten dieselbe Aufgabenstellung, aber in sehr unterschiedlichen Formen.
Die meisten Teams haben übrigens keines. Als wir im Juli 2026 149 Teams befragt haben, gaben nur 17 % an, ein Company Brain zu haben, das funktioniert. Weitere 27 % haben versucht, eines aufzubauen, und aufgegeben, fast immer an der Wartung und nicht an der Technologie.
Deshalb haben wir für unsere Company-Brain-101-Recherche ein Dutzend Produkte getestet und analysiert, die ein Company Brain versprechen, und mit mehr als zehn Menschen gesprochen, die gerade eines bauen.
Das Wichtigste in Kürze
- Jede Company-Brain-Lösung, ob Open Source oder kommerziell, besteht aus denselben vier Komponenten: Signale erfassen, Erinnern, Träumen und Ausmisten sowie Sprechen und Suchen.
- Der Markt teilt sich in vier Familien: selbst gehostete Muster, Memory-SDKs, etablierte Suite-Anbieter und dedizierte Company Brains. Jede wägt menschlichen Pflegeaufwand und Rechenkosten anders ab.
- Die Komponente, die ein funktionierendes Company Brain von einem veralteten Wiki unterscheidet, ist die Wartung. Nur eine Handvoll der untersuchten Tools automatisiert sie, und alle halten dabei einen Menschen im Prozess.
- Nur 17 % der befragten Teams haben ein Company Brain, das funktioniert. Genauigkeit (77 %) und Berechtigungen (63 %) sind die Bedenken, die entscheiden, welche Familie für Sie passt.
- Wenn Sie Entwickler mit Lust darauf haben und weniger als 50 Personen sind, hosten Sie selbst. Wenn Sie eigene Agenten bauen, nutzen Sie ein Memory-SDK. Alle anderen brauchen ein dediziertes Brain, das die Pflege automatisiert, ohne Ihren Kontext an eine einzelne Plattform zu binden.
Jedes Company Brain besteht aus denselben vier Komponenten
Für unser E-Book haben wir uns ein Dutzend Company-Brain-Lösungen von innen angesehen: Open Source und kommerziell, persönlich und unternehmensweit, selbst gebaut und gekauft. Sie unterscheiden sich fast überall.
Bis auf eine Stelle. Jedes besteht aus denselben vier Komponenten. Das Brain erfasst Signale, es erinnert sich, es träumt und misst aus, und es antwortet, wenn man es anspricht.
Signale erfassen
Beim Erfassen von Signalen lernt das Brain, was heute im Unternehmen passiert ist. Ein stetiger Zufluss sorgt dafür, dass es Ihr Unternehmen so beschreiben kann, wie es jetzt ist, egal ob ein Mensch darin sucht oder ein Agent Kontext daraus abruft.
Tools und Systems of Record wie CRM, Projektmanagement, Chat und Entwickler-Tools erzeugen Aktivität in unterschiedlichem Tempo und Umfang. Deshalb wägen die Erfassungsmethoden Aktualität gegen Kosten und Rauschen ab.
Vier Ansätze decken das Feld ab:
- Geplante Abrufe. Ein Konnektor synchronisiert jedes Tool in einem festen Intervall. Nützlich für langsam veränderliche Quellen wie Dokumente und CRM-Einträge.
- Ereigniserfassung. Ein Webhook schickt jedes Ereignis in dem Moment ans Brain, in dem es eintritt. Nützlich für schnelllebige Quellen wie Chat und Tickets.
- Agenten-Ingestion. Ein Agent liest eine Quelle, behält das Wesentliche und schreibt eine strukturierte Zusammenfassung ins Brain. Nützlich für verrauschte Quellen wie Meeting-Transkripte.
- Retrieval zur Abfragezeit. Es wird nichts gespeichert. Das Brain fragt die Live-Quellen in dem Moment ab, in dem eine Frage eintrifft. Nützlich, wenn das Quellsystem die einzige Kopie bleiben soll.
Erinnern
Erinnern ist die Form, in der das Brain Wissen ablegt, damit es wiedergefunden werden kann. Die Form entscheidet, welche Fragen das Brain später beantworten kann.
Reichhaltigere Formen beantworten mehr, kosten aber mehr im Aufbau und in der Pflege. Deshalb existieren vier nebeneinander:
- Einfache Dateien. Markdown in einem Git-Repo, lesbar für jeden Menschen und jeden Agenten. Nützlich für kleine technische Teams, die keine Infrastruktur wollen.
- Dokumente. Eine Wissensdatenbank mit Verantwortlichen und Berechtigungen. Nützlich, wenn vor allem Menschen lesen.
- Vektorindex. Alles wird eingebettet und nach Bedeutung statt nach Stichwörtern durchsucht. Nützlich für große Mengen unstrukturierter Inhalte.
- Wissensgraph. Entitäten und Beziehungen werden als typisierte Kanten gespeichert, in den reichhaltigsten Varianten mit einem Gültigkeitszeitraum für jeden Fakt. Nützlich, wenn Fragen Beziehungen oder Verläufe betreffen.
Manche Brains kombinieren bewusst zwei davon: lesbare Dokumente für Menschen plus eine dichte, strukturierte Ebene, die nur Agenten öffnen.
Träumen und Ausmisten
Träumen und Ausmisten ist die Art, wie das Brain sein eigenes Unternehmenswissen aktuell hält, ohne dass man es dazu auffordert.
- „Träumen" ist vom nächtlichen Dream Cycle von GBrain entlehnt: ein geplanter Job, in dem das Brain noch einmal liest, was es am Tag gelernt hat, es neu ordnet und neu verknüpft, so wie Schlaf Erinnerungen festigt.
- Ausmisten ist die andere Hälfte: Es verabschiedet, was nicht mehr gilt.
Unternehmenskontext veraltet auf verschiedene Weise:
- durch Alter,
- durch Nichtbenutzung,
- oder durch Widerspruch zu dem, was in Ihren Tools tatsächlich passiert.
Jede Art braucht ihre eigene Routine:
- Konsolidierungsläufe. Ein geplanter Job ordnet alles neu und verknüpft es neu, was an diesem Tag hereingekommen ist. Nützlich, um das Gedächtnis beim Wachsen konsistent zu halten.
- Zeitlicher Verfall. Alte und ungenutzte Fakten verlieren Gewicht beim Abruf oder laufen ganz ab. Nützlich gegen stilles Veralten.
- Abweichungserkennung. Das Brain vergleicht, was Dokumente behaupten, mit der Live-Aktivität in den verbundenen Tools, und meldet Unstimmigkeiten. Nützlich, um Seiten zu finden, die von der Realität überholt wurden.
- Prüfwarteschlangen. Jede Änderung, die das Brain vorschlägt, wartet in einem Posteingang auf die Freigabe durch einen Menschen. Nützlich überall dort, wo ein falsches Update mehr kostet als ein langsames.
Sprechen und Suchen
Sprechen und Suchen ist der Punkt, an dem alles zusammenkommt: der Ort, an dem Menschen tatsächlich suchen, und der Ort, an dem Agenten ihren Kontext abrufen. Unterschiedliche Fragende brauchen unterschiedliche Türen. Menschen wollen ein Gespräch. Maschinen wollen einen Endpunkt.
- Chat. Fragen in normaler Sprache, Antworten mit Quellenangaben. Nützlich für alltägliche Teamfragen.
- Hybride Suche. Suche nach Bedeutung und nach exaktem Stichwort gleichzeitig, danach werden die Ergebnisse neu sortiert. Nützlich als Unterbau für jeden anderen Modus.
- Headless-API oder MCP. Das Brain als Endpunkt, den andere Systeme direkt abfragen. Nützlich, um das Brain an Coding-Agenten, Support-Bots und Workflows anzubinden.
- Dedizierte Apps. Speziell gebaute Oberflächen für ein bestimmtes Team oder einen bestimmten Workflow. Nützlich, wenn ein Anwendungsfall eine eigene Oberfläche verdient.
Keine Lösung setzt all das gleichzeitig ein. Jede wählt pro Komponente eine einzige Option, und genau diese Entscheidungen sorgen dafür, dass sich zwei Company Brains völlig unterschiedlich verhalten.
| Signale erfassen | Erinnern | Träumen und Ausmisten | Sprechen und Suchen |
|---|---|---|---|
| Geplante Konnektor-Abrufe | Einfaches Markdown in einem Git-Repo | Nächtliche Konsolidierungsläufe | Chat mit Quellenangaben |
| Webhook- und Ereigniserfassung | Wiki- oder Wissensdatenbank-Dokumente | Zeitlicher Verfall und Ablauf von Fakten | Hybride Suche |
| Agentengesteuerte Ingestion, die Quellen strukturiert | Vektorindex über alles | Abweichungserkennung gegenüber Live-Tools | Headless-API / MCP in andere Tools |
| Retrieval zur Fragezeit, nichts speichern | Ontologischer oder zeitlicher Kontextgraph | Prüfwarteschlange für jede Änderung | Dedizierte App-Oberflächen |
Die vier Familien von Company-Brain-Lösungen
Jede Lösung auf dem Markt geht bei den fünf Bedenken, die unsere Umfrageteilnehmer am häufigsten nannten, einen anderen Kompromiss ein: Genauigkeit (77 %), Datenschutz und Berechtigungen (63 %), Wartungsaufwand (58 %), Kosten für tägliche Ingestion und Pflege (58 %) und Einrichtungsaufwand (33 %). Am einfachsten sieht man den Kompromiss als Kosten gegen Kosten: was Sie für menschliche Pflege zahlen im Vergleich zu dem, was Sie für Rechenleistung und Abonnements zahlen.
So aufgetragen, teilt sich der Markt in vier Familien.
| Familie | Für wen | Was sie bietet | Was sie Sie kostet |
|---|---|---|---|
| Selbst gehostete Muster (GBrain, Sylph, selbst gebaut) | Technische Teams, die volle Souveränität wollen | Open Source, einfache Dateien, nahezu keine Betriebskosten, vollständige Portabilität | Die Wartung liegt komplett bei Ihren Mitarbeitenden. Das ist die Geschichte der 27 %. |
| Memory-SDKs (mem0, Letta, Zep) | Entwickler, die eigene Agenten bauen | Open-Core-Bausteine, automatische Extraktion, zeitliche Graphen | Alles oberhalb der Memory-Schicht bauen und justieren Sie selbst |
| Etablierte Suite-Anbieter (Notion AI, Rovo, Slack AI, Glean, ChatGPT und Claude Enterprise) | Organisationen, die schon in einer einzigen Suite arbeiten | Geringster Einrichtungsaufwand, berechtigungsbewusst ab Werk | Kontext-Lock-in: Ihr Brain gehört der Plattform |
| Dedizierte Company Brains (Slite Agent, Carrara, Pletor) | Teams, die die Schicht unabhängig von Modellen und Plattformen wollen | Automatisierte Wartung mit menschlicher Prüfung, Portabilität als Funktion | Ein Abonnement, und Sie vertrauen einem Anbieter die ganze Schicht an |
Die meisten Teams haben schon irgendeine Version der dritten Familie. Jede große Plattform baut ein Brain auf dem Ausschnitt an Kontext, den sie bereits besitzt:
- Salesforce mit Slack AI,
- Atlassian mit Rovo,
- Notion mit Notion AI,
- Microsoft und Google innerhalb ihrer Suiten,
- OpenAI und Anthropic von der Modellseite aus.
Sie sind am schnellsten eingeschaltet. Der Haken ist das, was wir Kontext-Lock-in nennen.
Ein Company Brain muss über jede Quelle hinweg lesen. Das bedeutet, wer es betreibt, hält die vollständigste und portabelste Version Ihres Unternehmens, die es je an einem Ort gab.
Wenn diese Schicht einer Plattform gehört, die Sie nicht verlassen können, zahlen Sie für den Lock-in bei jeder Antwort, jedem Agenten und jedem Workflow, die darauf aufbauen.
Die Schraube zieht sich bereits an: Seit Mitte 2025 können Drittanbieter-Tools Slack-Nachrichten nicht mehr in großen Mengen indizieren, und Apps, die nicht im Marketplace sind, werden gedrosselt und dürfen keine historischen Daten behalten.
Derselbe Kompromiss zeigt sich bei vielen Suite-eigenen Tools, weshalb Teams anfangen, nach Alternativen zu suchen, sobald der Lock-in teuer wird.
10 Company-Brain-Lösungen und was jede davon tatsächlich einsetzt
Zu jedem Tool: was es ist, für wen es gedacht ist und welche vier Komponentenentscheidungen es trifft, entnommen aus der öffentlichen Dokumentation und, wo wir sie bekommen konnten, aus Gesprächen mit den Menschen, die es bauen. Die Einträge sind nach Familie gruppiert, ohne konkrete Rangfolge.
Selbst gehostete Muster
1. Selbst gebaut: Claude Code + ein Git-Repo
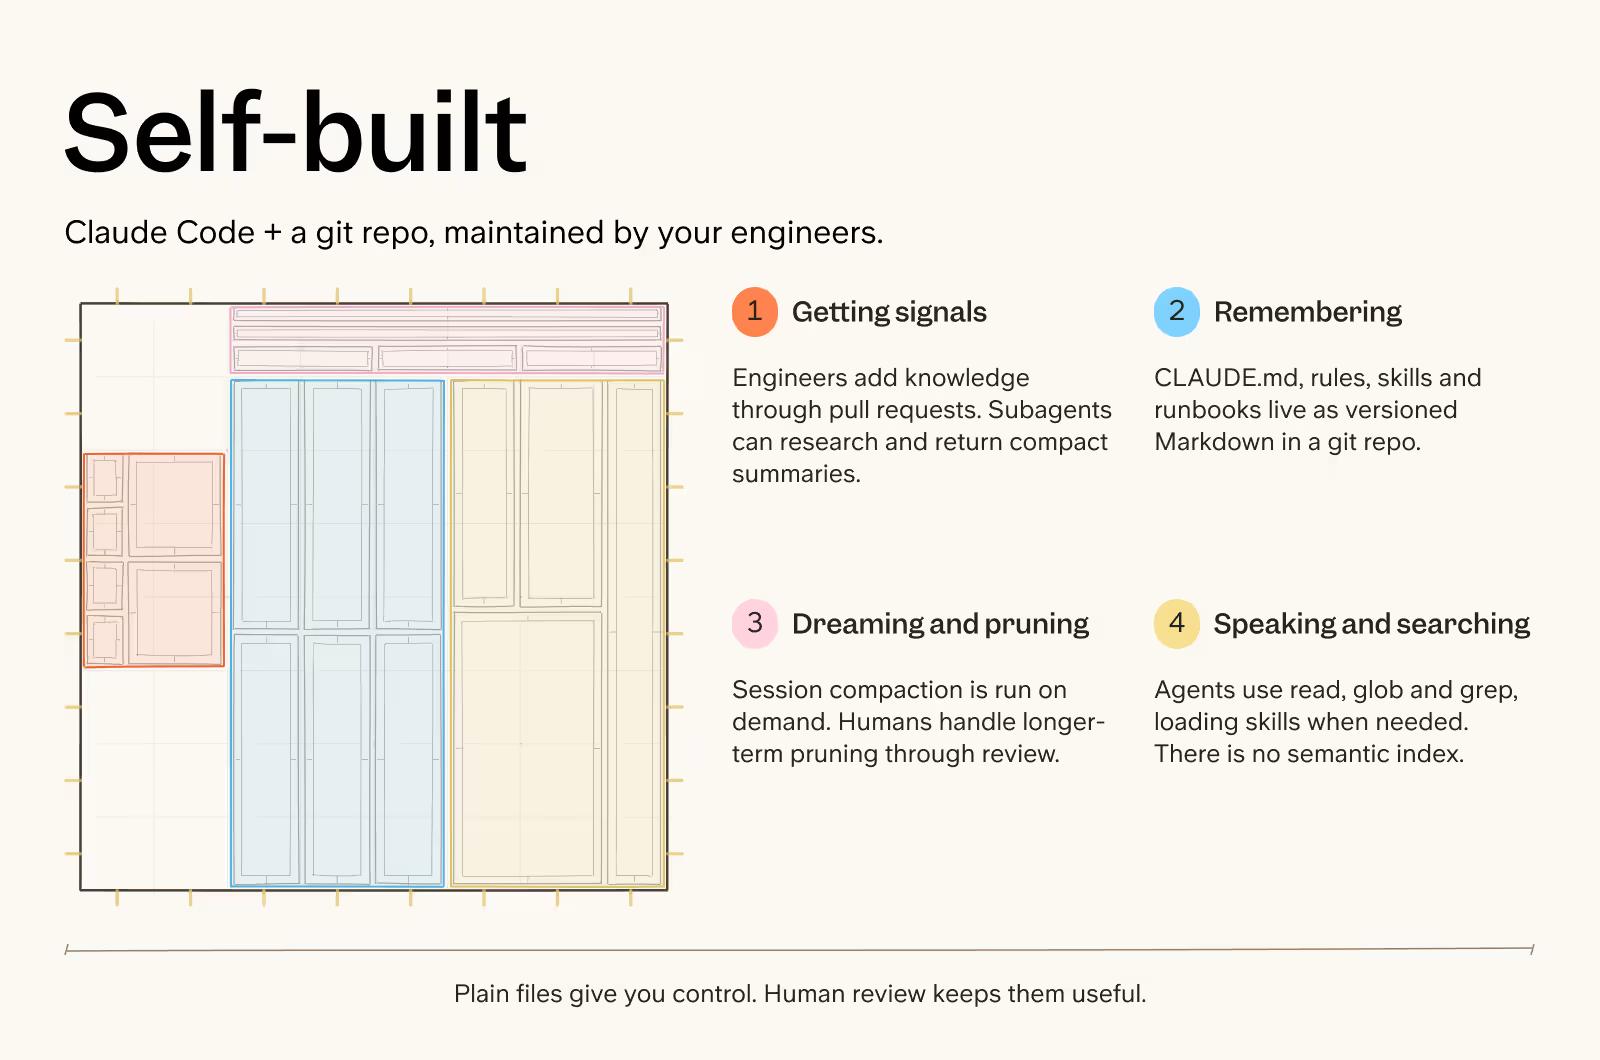
Das Muster, mit dem die Hälfte unserer Umfrageteilnehmer startete, die ein Company Brain ausprobiert haben: ein Coding-Agent, der an ein Repository aus Markdown, Pull Requests und einfacher Dateisuche angebunden ist. Kein Produkt, kein Anbieter, und ein Entwickler, der es gesund hält.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Entwickler ergänzen und aktualisieren Wissen über Pull Requests. Subagenten können parallel recherchieren und dann kompakte Zusammenfassungen zurückgeben, die der übergeordnete Agent speichert. |
| Erinnern | Das Gedächtnis liegt im Git-Repo: CLAUDE.md, Regeln, Skills, Runbooks und andere Markdown-Dateien, alle versioniert zusammen mit dem Rest des Systems. |
| Träumen und Ausmisten | Die Sitzungskompaktierung ist ein Befehl, den Sie ausführen, wenn der Kontext eng wird. Das langfristige Ausmisten geschieht durch menschliche Prüfung, meist in Pull Requests. |
| Sprechen und Suchen | Agenten nutzen read, glob und grep, um Kontext in einfachen Dateien zu finden, und laden Skills nur bei Bedarf. Es gibt keinen semantischen Index. |
Kosten und Eignung. Kostenlos, abgesehen von der Modellnutzung. Ideal für technikgeführte Teams unter 50 Personen, die volle Kontrolle wollen und es in Kauf nehmen, dass Kuratieren eine dauerhafte Pflichtaufgabe ist. Welche Workflows das ermöglicht, lesen Sie in warum Claude Code ein Company Brain braucht.
2. GBrain
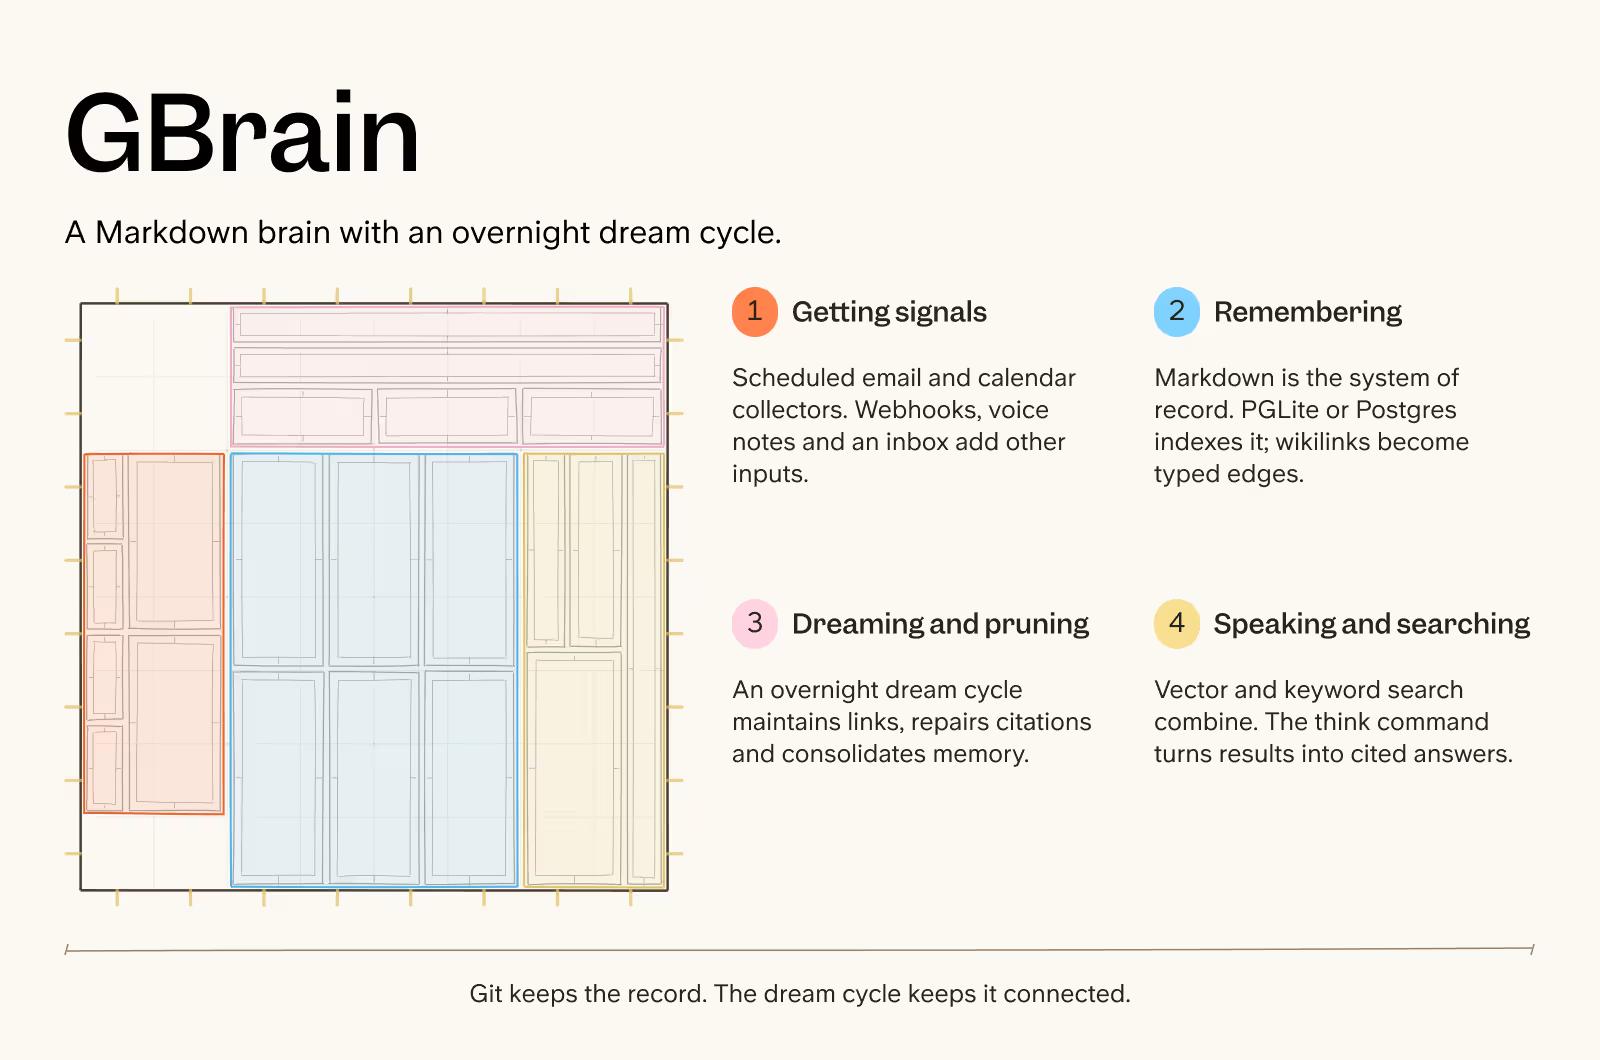
GBrain ist das Open-Source-Personal-Brain, das Garry Tan im April 2026 veröffentlicht hat, und das Projekt, das den YC Request for Startups zu einer Kategorie gemacht hat. Git hält die dauerhafte Aufzeichnung. Ein geplanter Dream Cycle pflegt über Nacht den Graphen und konsolidiert das Gedächtnis.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | E-Mails und Kalender kommen über geplante Collectors herein. Allgemeine Webhooks, Sprachnotizen, ein Eingangsordner und eigene Skillpacks bieten weitere Wege, das Brain zu füttern. |
| Erinnern | Ihr Markdown-Repo bleibt das System der Wahrheit. GBrain indiziert es standardmäßig mit PGLite, bei gemeinsamen Deployments mit Postgres und pgvector, und macht aus lokalen Wikilinks ohne LLM typisierte Kanten. |
| Träumen und Ausmisten | Planen Sie den Dream Cycle über Nacht, dann pflegt GBrain Links, repariert Quellenangaben und konsolidiert das Gedächtnis. Der Befehl „think" benennt außerdem veralteten Kontext, unbelegte Behauptungen und Widersprüche. |
| Sprechen und Suchen | Die Suche verbindet Vektor- und Stichwortabruf mit Rank Fusion. Drei Suchmodi wägen Kosten gegen Qualität ab, und „think" macht aus den Ergebnissen eine Antwort mit Quellenangaben. |
Kosten und Eignung. Kostenlos im Betrieb, abgesehen von Ihren eigenen Embedding- und Modellkosten. In erster Linie für den Kontext einer einzelnen Person gebaut; als Company Brain funktioniert es für ein kleines technisches Team, das sich im Terminal wohlfühlt. Wenn Sie nach GBrain-Alternativen suchen, sind die nächsten Sylph (siehe unten) für ein gemeinsames Repo sowie mem0 oder Zep für eine Memory-Schicht unter Ihren eigenen Agenten. Wir haben es ausführlich besprochen in GBrain im Test.
3. Sylph
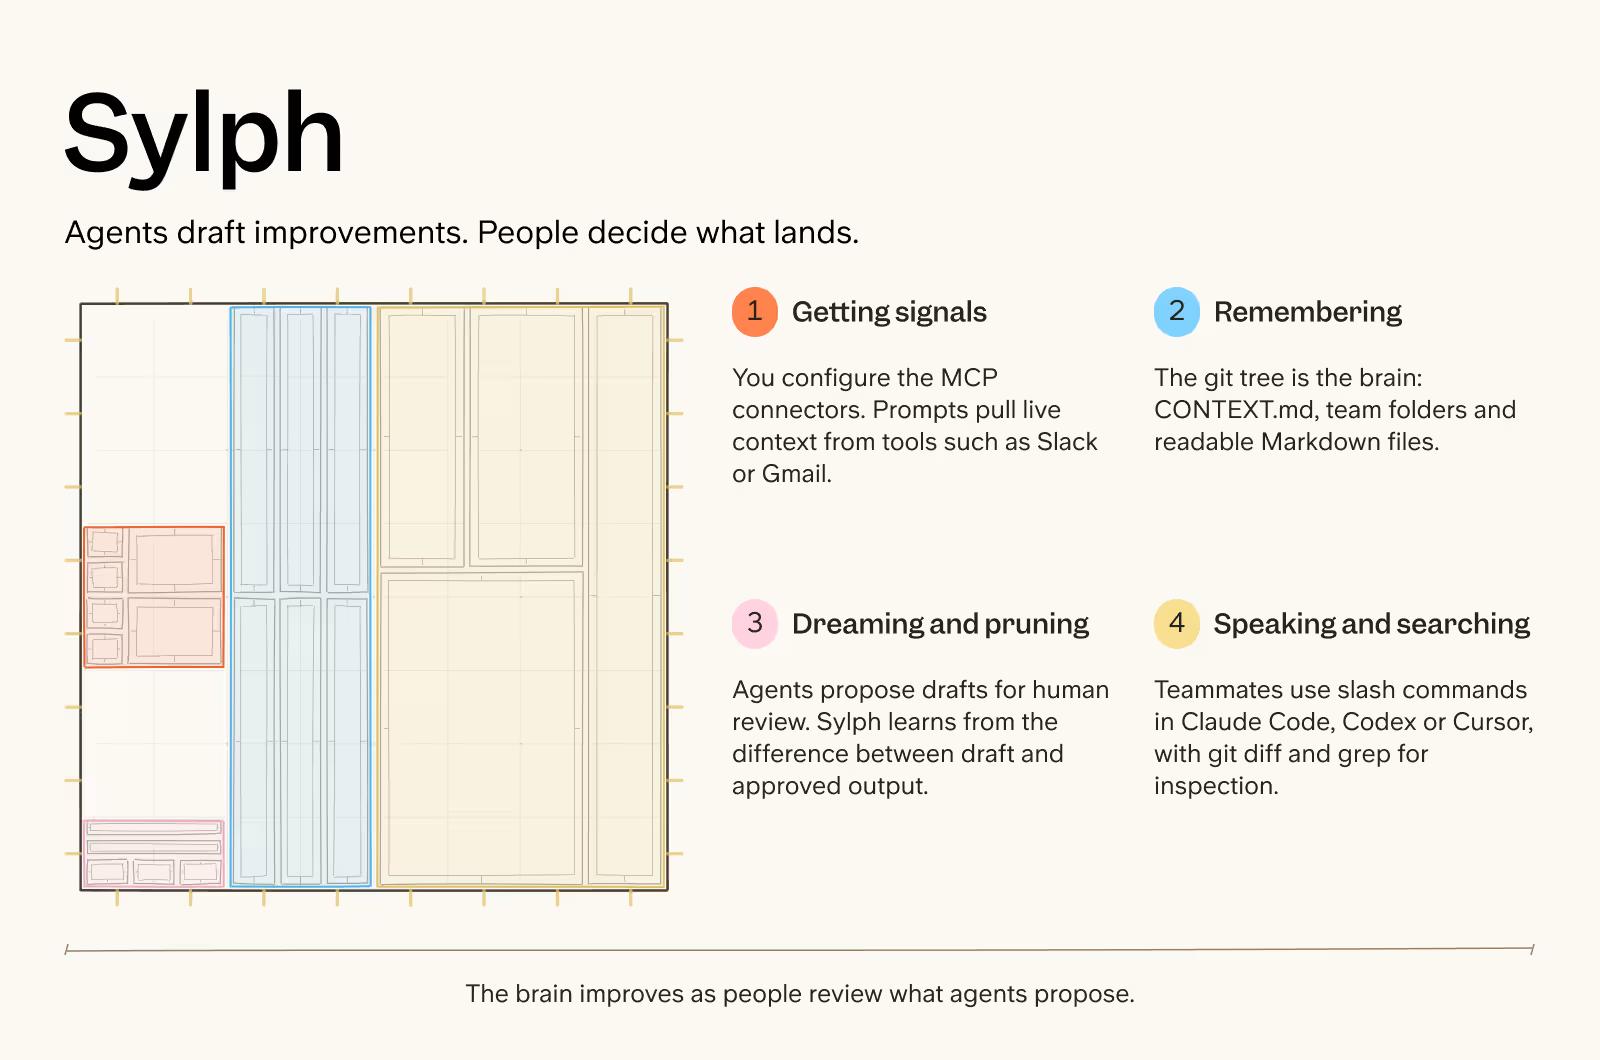
Sylph von nao Labs hält das Company Brain in einem Git-Repo, das Sie selbst lesen und gestalten können. Agenten können Verbesserungen entwerfen, aber Menschen entscheiden, was übernommen wird.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Sylph bringt keine externen Datenquellen mit. Sie wählen und konfigurieren die MCP-Konnektoren, die es nutzen kann, sodass Prompts Live-Kontext aus Tools wie Slack oder Gmail ziehen können. |
| Erinnern | Das Brain ist der Git-Baum selbst: eine zentrale CONTEXT.md, Domänenordner für Teams wie Marke, Vertrieb, Produkt, HR und Recht sowie Markdown-Dateien, die die Agenten lesen können. |
| Träumen und Ausmisten | Agenten legen vorgeschlagene Verbesserungen in einem Entwurfsordner zur menschlichen Prüfung ab. Sobald jemand ein Ergebnis freigibt, vergleicht Sylph den Entwurf mit dem, was übernommen wurde, und aktualisiert seine eigenen Regeln anhand des Unterschieds. |
| Sprechen und Suchen | Teammitglieder arbeiten über Slash-Befehle in Claude Code, Codex oder Cursor. Weil das Gedächtnis aus einfachem Markdown in Git besteht, können Menschen Änderungen mit vertrauten Tools wie git diff und grep prüfen. |
Kosten und Eignung. Kostenlos und Open Source. Ein Gründerteam, das seinen Betrieb ohnehin über Coding-Agenten steuert, wird sich hier zu Hause fühlen. Der Preis dafür: Nichts ist automatisiert, das Brain wird nur so schnell besser, wie ein Mensch Entwürfe prüft.
Memory-SDKs
4. mem0
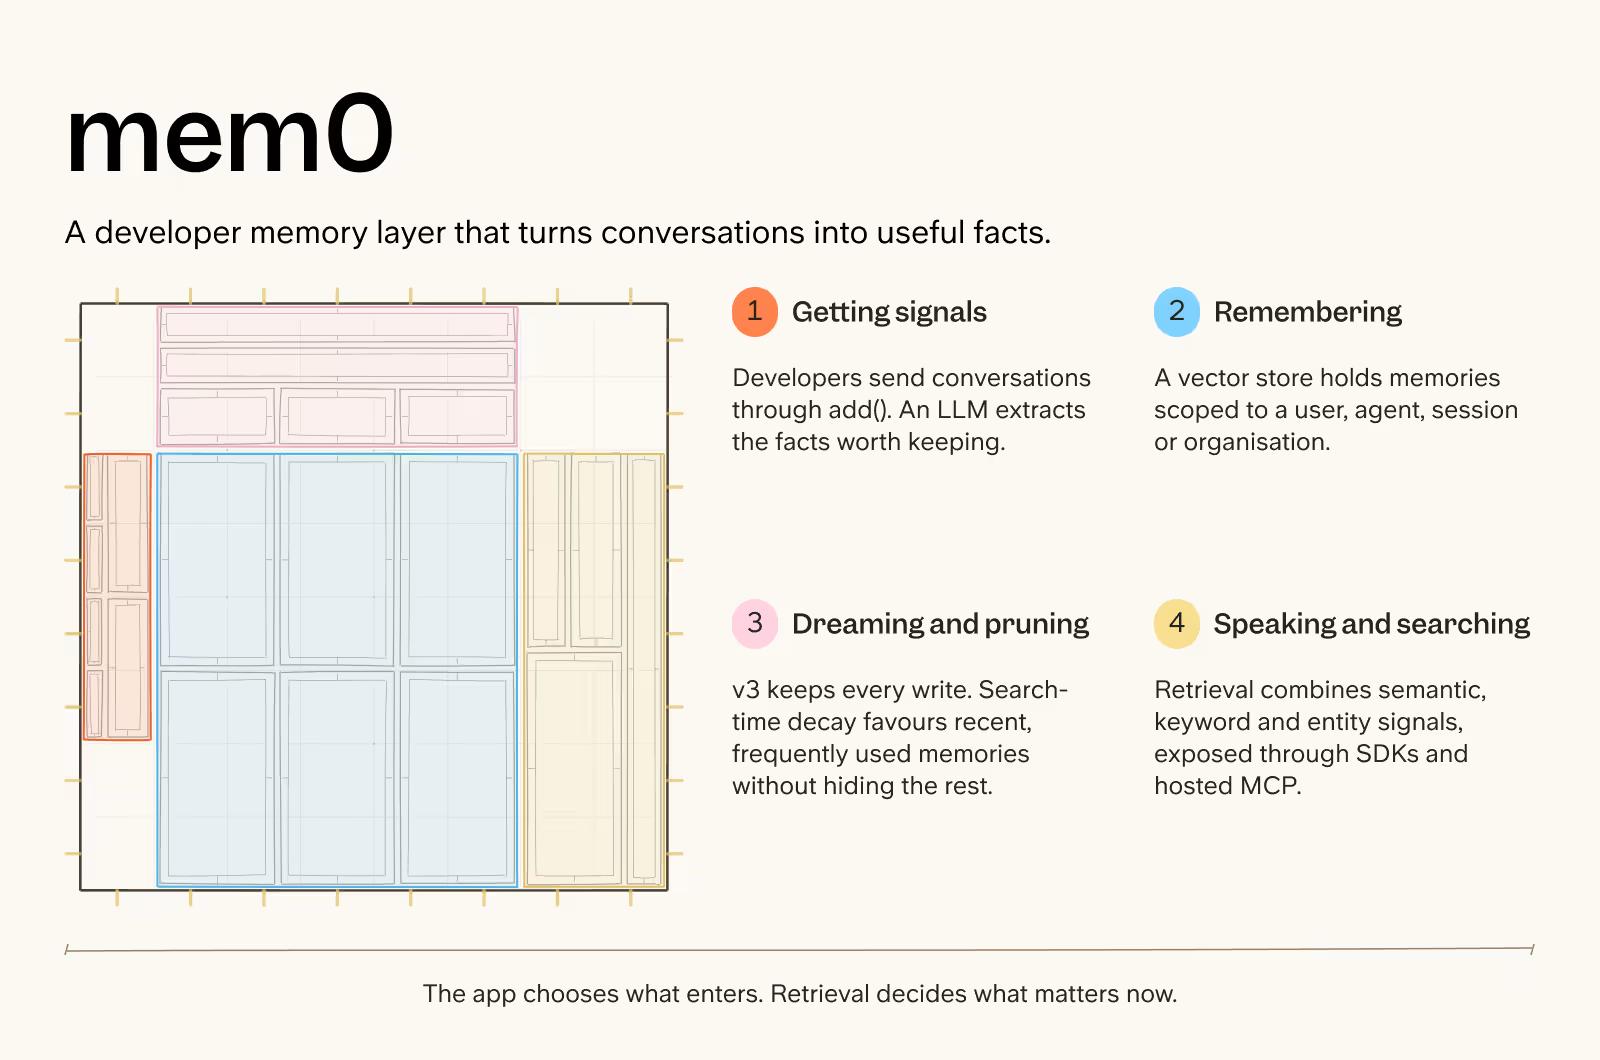
mem0 ist eine Memory-Schicht für Entwickler, die Gespräche in nützliche Fakten verwandelt und die passenden zurückbringt, wenn eine App sie braucht. Es ist die am weitesten verbreitete Option dieser Familie, mit einer gehosteten Plattform auf dem Open-Source-Kern.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Entwickler entscheiden per add()-Aufruf, wann ein Gespräch übergeben wird. mem0 nutzt ein LLM, um die behaltenswerten Fakten herauszuziehen. Die Ingestion beginnt also innerhalb der App und nicht nach einem Zeitplan. |
| Erinnern | Erinnerungen liegen in einem Vektorspeicher und können auf einen Nutzer, Agenten, eine Sitzung oder eine Organisation begrenzt werden. Die Entitätsextraktion ist in der Open-Source-Version enthalten, der interaktive Graph läuft auf der gehosteten Plattform. |
| Träumen und Ausmisten | v3 behält jeden Schreibvorgang, statt alte Erinnerungen zu aktualisieren oder zu löschen. Bei der Suche bevorzugt der Memory-Verfall sanft aktuelle, häufig genutzte Erinnerungen, ohne die übrigen zu verbergen. |
| Sprechen und Suchen | Wenn die App Kontext anfragt, kombiniert mem0 semantische Suche mit Stichwort- und Entitätssignalen. Entwickler können die SDKs nutzen oder sich über den gehosteten MCP-Server verbinden. |
Kosten und Eignung. Open Source ist kostenlos. Die gehostete Plattform hat eine kostenlose Stufe und nutzungsbasierte Tarife. Wählen Sie es, wenn Sie eigene Agenten bauen und ein Gedächtnis wollen, das einfach funktioniert, und nehmen Sie in Kauf, dass Sie alles oberhalb der Memory-Schicht selbst zusammensetzen.
5. Zep / Graphiti
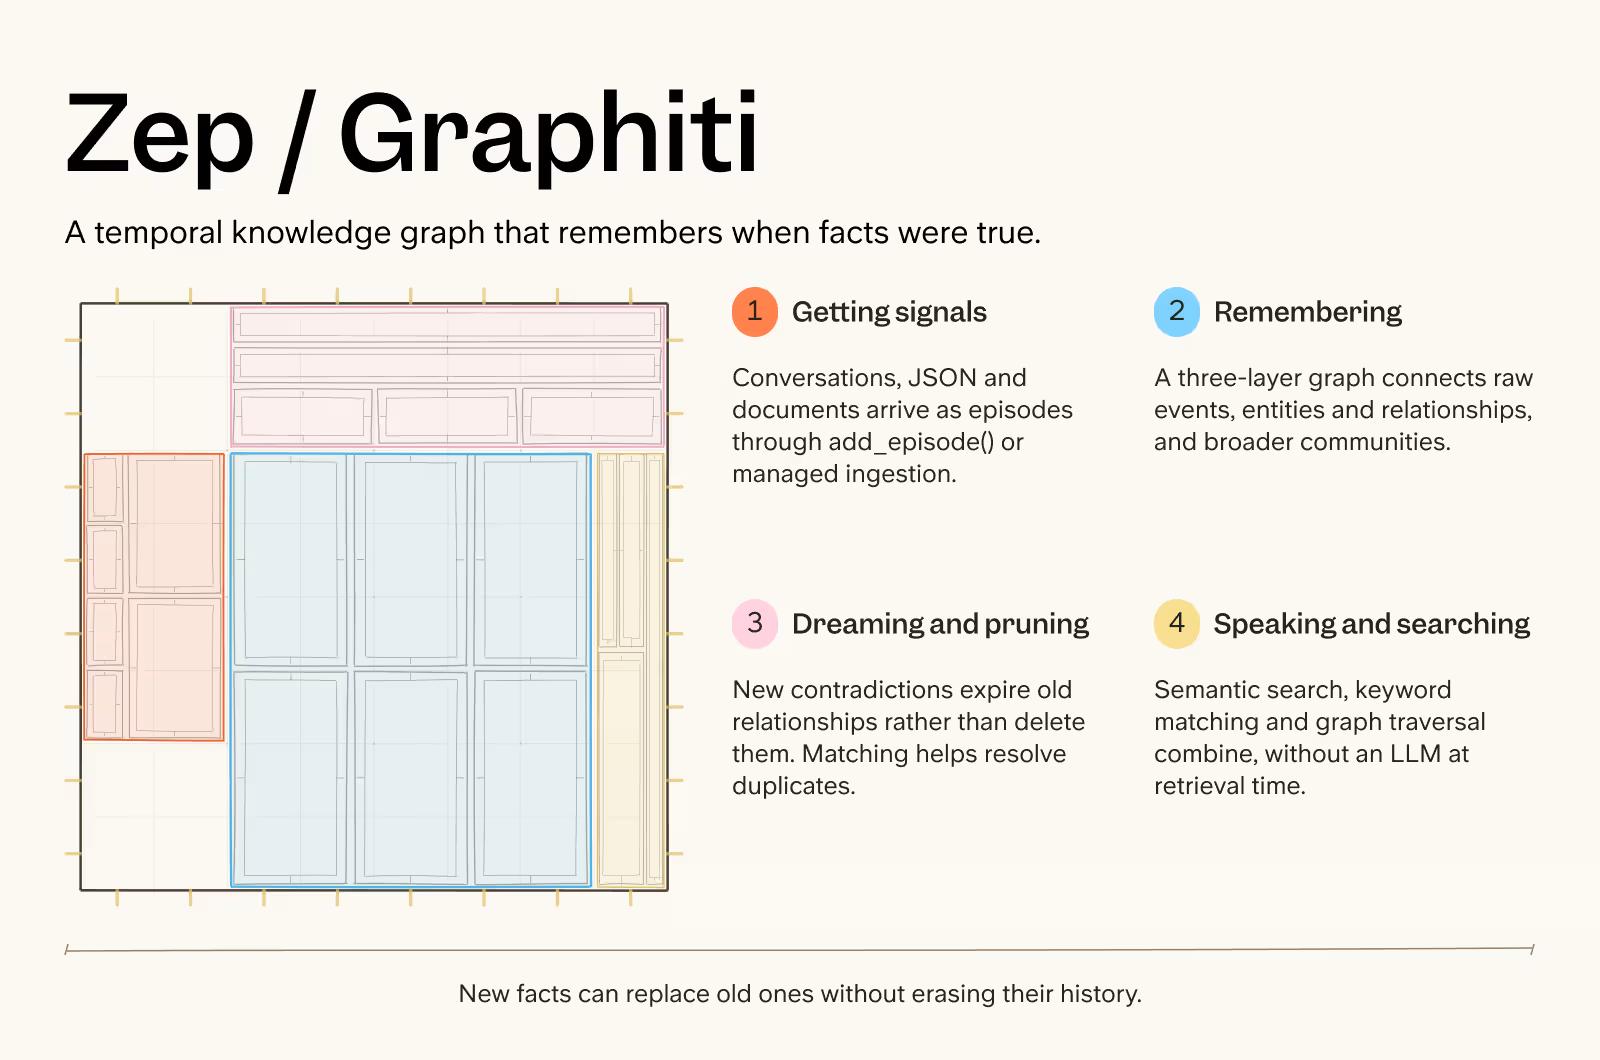
Zep führt einen zeitlichen Graphen aus Personen, Ereignissen und Fakten und markiert alte Informationen als abgelaufen, sobald etwas Neueres sie überholt. Graphiti ist die Open-Source-Graph-Engine darunter.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Gespräche, JSON und Dokumente kommen als Episoden über einen add_episode()-Aufruf oder Zeps verwaltete Ingestion-Pipeline herein. |
| Erinnern | Jede Episode speist einen Wissensgraphen mit drei Ebenen: rohe Ereignisse, extrahierte Entitäten und Beziehungen sowie übergeordnete Communities. Fakten werden eingebettet und mit Zeitstempel versehen, sodass der Graph sich sowohl merkt, was geschah, als auch, wann es galt. |
| Träumen und Ausmisten | Wenn neue Informationen einem älteren Fakt widersprechen, markiert ein LLM die alte Beziehung als abgelaufen, statt sie zu löschen. Entropiegesteuertes Fuzzy Matching hilft, wahrscheinliche Duplikate aufzulösen, ohne mehrdeutige Namen zusammenzuwerfen. |
| Sprechen und Suchen | Zur Abfragezeit kombiniert Zep semantische Suche, Stichwortabgleich und Graph-Traversierung. Da der Abruf kein LLM braucht, kommen Ergebnisse in deutlich unter einer Sekunde zurück. |
Kosten und Eignung. Graphiti ist kostenlos. Zeps Cloud ist Freemium mit Enterprise-Stufen. Die richtige Wahl, wenn Ihre Fragen den Verlauf betreffen („Was galt im März?") und Sie Entwickler haben, die den Abruf feinjustieren.
6. Letta
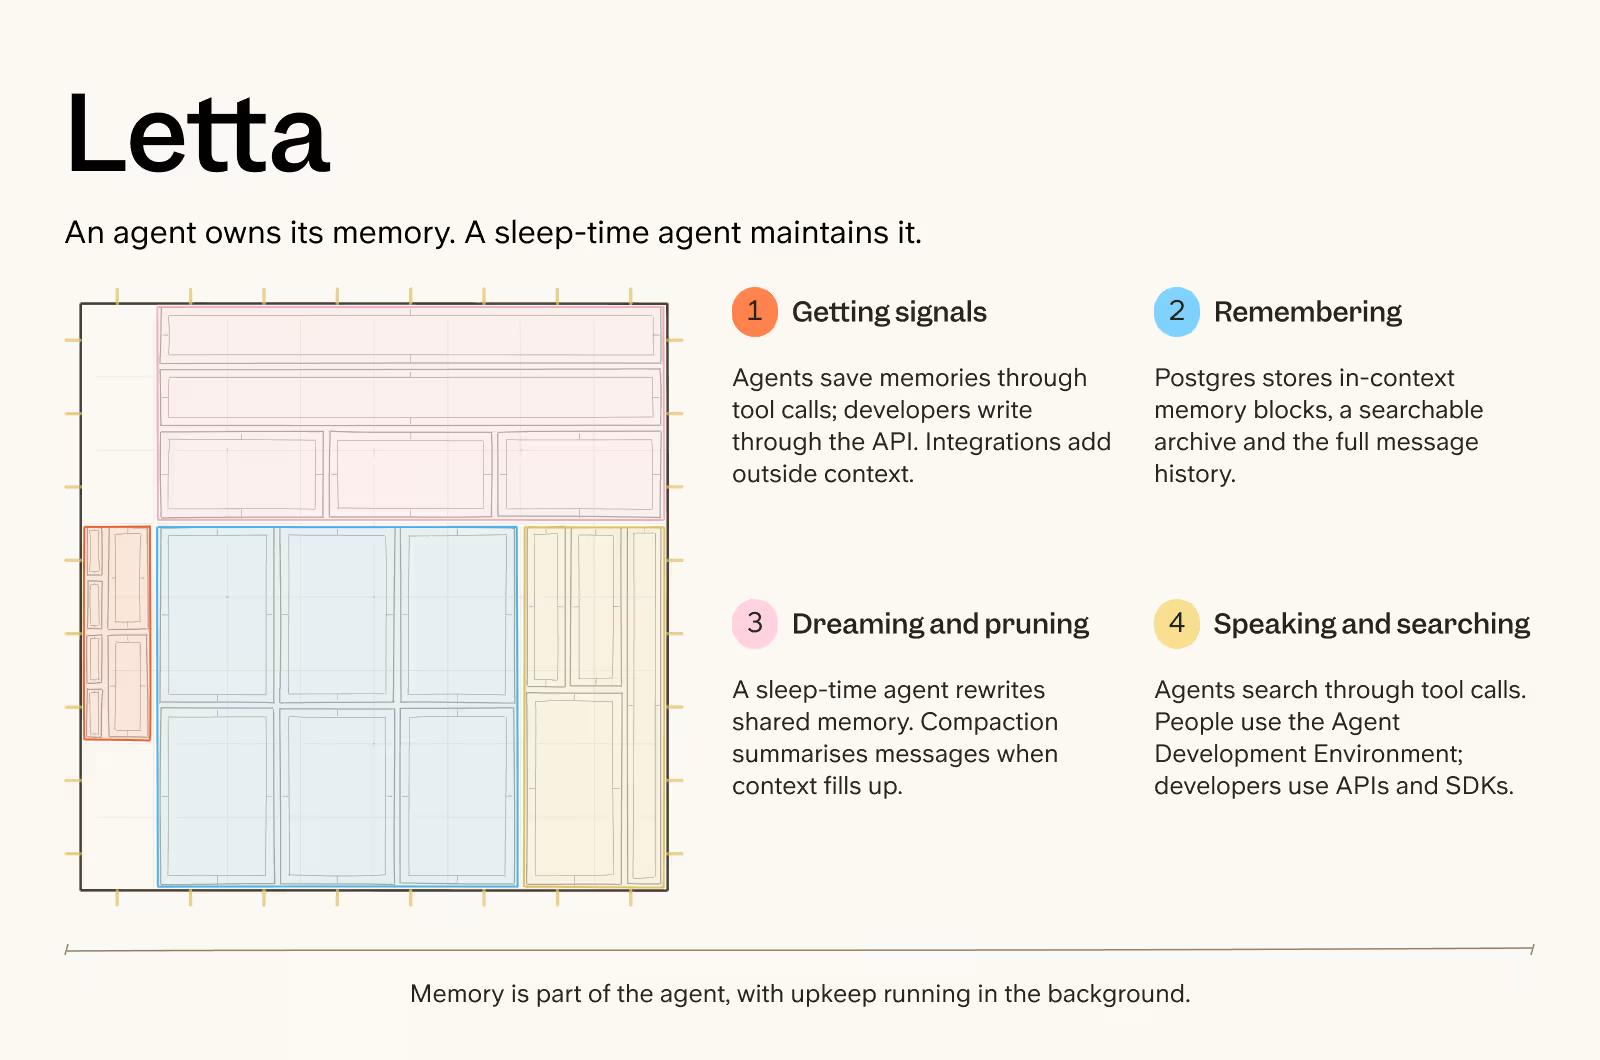
Bei Letta entscheidet der Agent, was ins Gedächtnis gehört, während ein Sleep-Time-Agent im Hintergrund am gemeinsamen Kontext arbeitet. Es ging aus dem MemGPT-Forschungspapier hervor und ist die akademisch fundierteste Option hier.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Der Agent kann Erinnerungen über eigene Tool-Aufrufe speichern und aktualisieren, während Entwickler über die API schreiben können. Native Integrationen für Slack, Telegram und GitHub können externen Kontext einbringen. |
| Erinnern | Das Gedächtnis ist in drei Ebenen geteilt: kleine beschriftete Blöcke, die im Kontext bleiben, ein durchsuchbares Archiv außerhalb des Kontextfensters und der vollständige Nachrichtenverlauf. Letta speichert sie in Postgres. |
| Träumen und Ausmisten | Ein Sleep-Time-Agent schreibt das gemeinsame Gedächtnis im Hintergrund um. Wenn sich der Kontext füllt, fasst die Kompaktierung etwa 30 % der Nachrichten zusammen und behält den Rest. |
| Sprechen und Suchen | Der Agent durchsucht und aktualisiert das Gedächtnis über Tool-Aufrufe. Menschen können es in der Agent Development Environment einsehen und bearbeiten, während Entwickler über REST-APIs und SDKs arbeiten. |
Kosten und Eignung. Open Source ist kostenlos; Letta Cloud wird nach Nutzung abgerechnet. Am besten für Teams, die zustandsbehaftete Agenten ausliefern und wollen, dass der Agent, nicht eine Pipeline, sein Gedächtnis besitzt.
Vertikale und interne Brains
7. Pletor
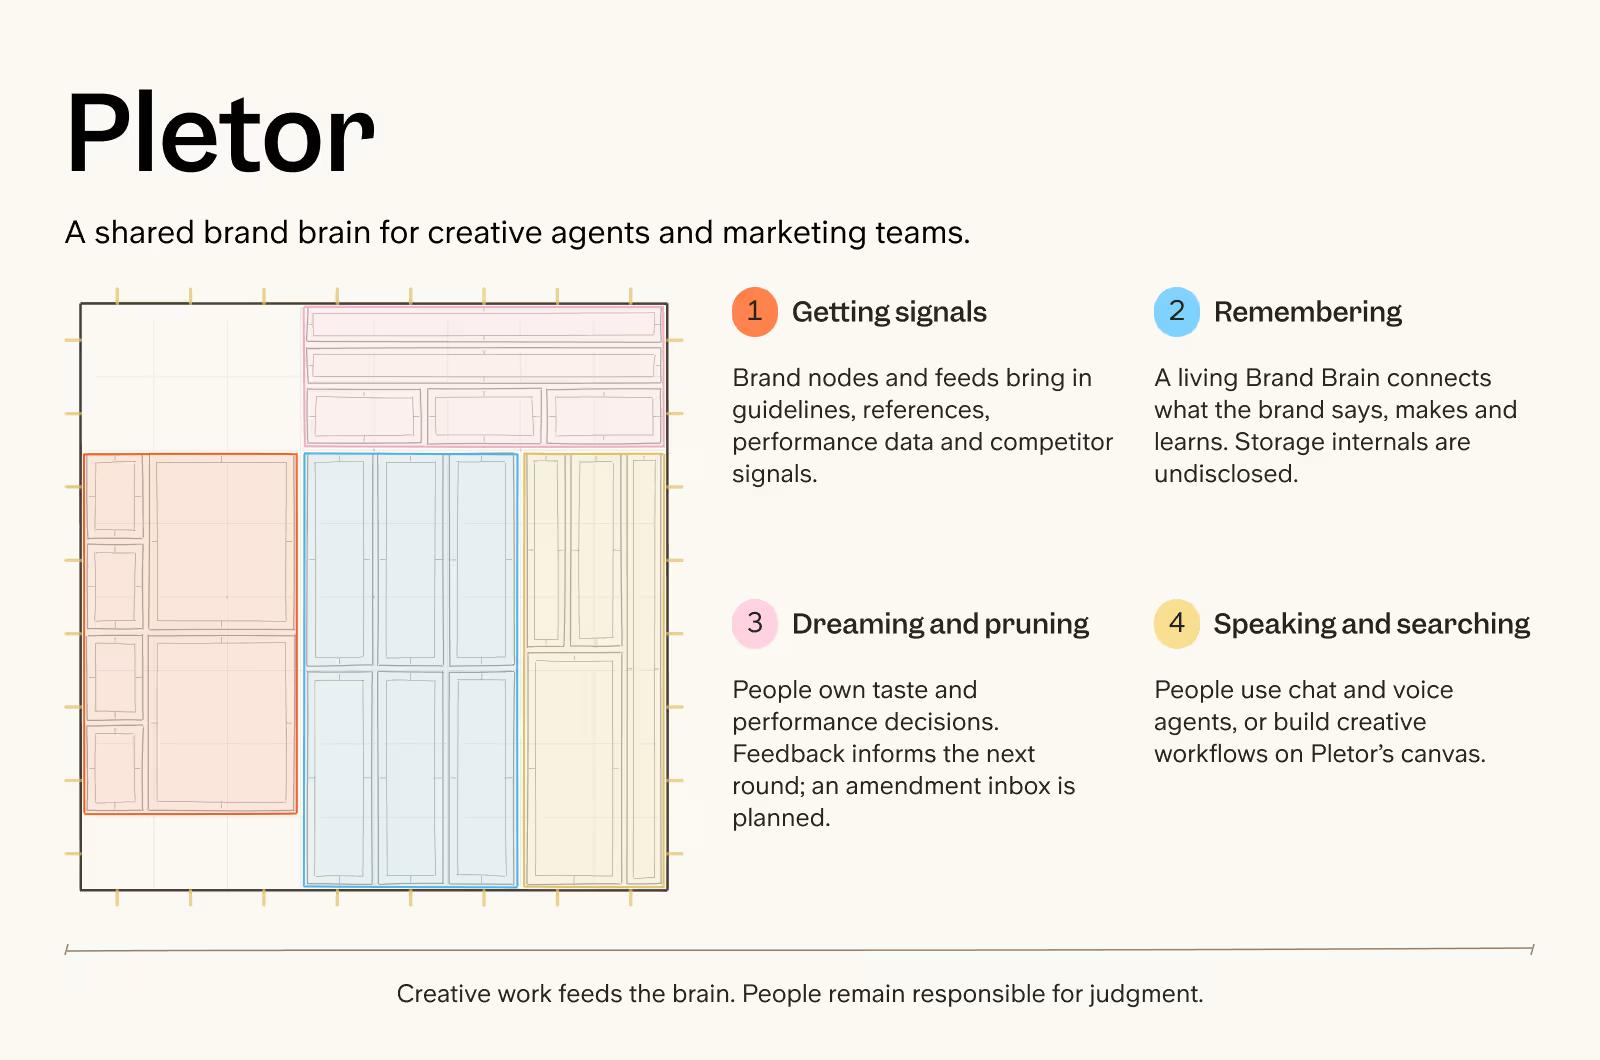
Pletor macht aus Markenregeln, kreativen Referenzen und Performance-Daten ein gemeinsames Gedächtnis, das seine Kreativ-Agenten nutzen können. Es ist ein Brand Brain für Marketingteams und kein Brain für das ganze Unternehmen, und es steht in dieser Liste, weil es zeigt, wie das Muster aussieht, wenn es auf eine einzelne Funktion zugeschnitten ist.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Brand-Knoten und Datenfeeds bringen Richtlinien, Referenzen, Performance-Daten und Wettbewerbssignale herein. Das System arbeitet mit Text, Bildern, Video und Audio. |
| Erinnern | Pletor hält diese Eingaben in einem lebendigen Brand Brain zusammen und verbindet, was die Marke sagt, erschafft und aus der Performance lernt. Die Speicherinterna sind nicht offengelegt. |
| Träumen und Ausmisten | Menschen bleiben für Geschmacks- und Performance-Entscheidungen verantwortlich, während Feedback und Ergebnisse in die nächste kreative Runde einfließen. Ein Posteingang für Änderungen am Brain, abgeleitet aus Ihren Chats, steht auf der Roadmap. |
| Sprechen und Suchen | Menschen arbeiten mit dem Brain über Chat- und Sprach-Agenten oder bauen kreative Workflows auf Pletors Canvas. |
Kosten und Eignung. Freemium mit kostenpflichtigen Team-Tarifen. Passend für Marketingteams, deren Agenten standardmäßig zur Marke passen sollen. Seine Gründer waren außerdem die offensten Gesprächspartner, wenn es um die Grenzen von Autonomie ging: „Das Versprechen eines offenen Claude, der aus Ihrem Slack lernt und einfach Dinge erledigt, ist verlockend. Aber es ist ziemlich schwer umzusetzen."
8. Gorgias Cortex
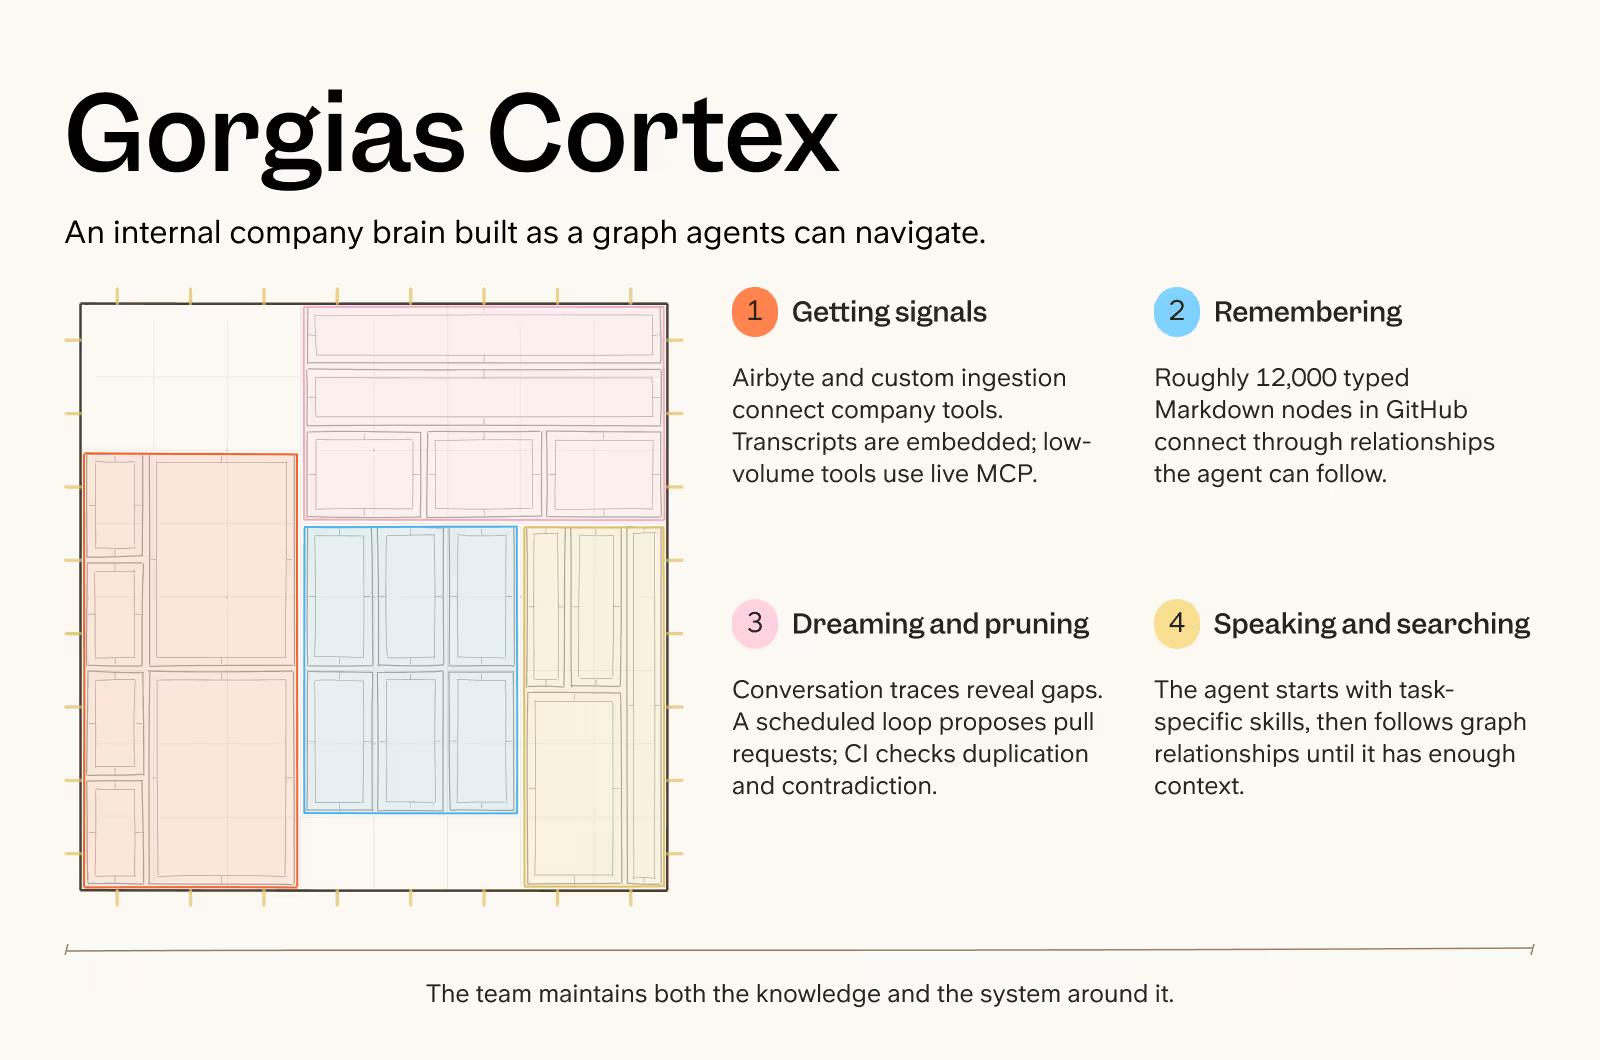
Gorgias hat Cortex aus den Systemen gebaut, die seine Teams ohnehin nutzen, und macht so Unternehmenswissen zu einem Graphen, in dem seine Agenten navigieren können. Es ist ein internes Projekt und kein Produkt, und das vollständigste selbst gebaute Company Brain, das wir untersucht haben.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Airbyte und ein eigenes Ingestion-Tool bringen Postgres, Notion, Gong, GitHub, Linear und HubSpot herein. Lange Transkripte werden in Abschnitte zerlegt und eingebettet, damit sie durchsuchbar bleiben; Tools mit geringem Volumen werden live über MCP abgefragt. |
| Erinnern | Das Ergebnis ist ein Wissensgraph aus rund 12.000 typisierten Markdown-Knoten in GitHub, verbunden durch Beziehungen, denen der Agent folgen kann. |
| Träumen und Ausmisten | Das Team untersucht Gesprächsverläufe, um fehlenden Kontext zu erkennen. Eine geplante Wartungsschleife bündelt wiederkehrende Lücken zu Pull Requests, die den Graphen verbessern, und CI-Prüfungen fangen Duplikate und Widersprüche vor dem Merge ab. |
| Sprechen und Suchen | Der Agent beginnt mit aufgabenspezifischen Skills und folgt dann den Beziehungen im Graphen, bis er genug Kontext für eine Antwort hat. Eine typische Abfrage kostet 10 bis 30 Cent. |
Kosten und Eignung. Nicht käuflich, und genau das ist die Lehre. Gorgias kann sich beide Aufgaben leisten, die ein selbst gebautes Brain verlangt, nämlich den Inhalt zu kuratieren und das System neu zu architektieren, während sich das Feld bewegt, weil es ein internes KI-Team aus acht Personen hat. Die meisten Unternehmen haben das nicht.
Dedizierte Company Brains
9. Carrara
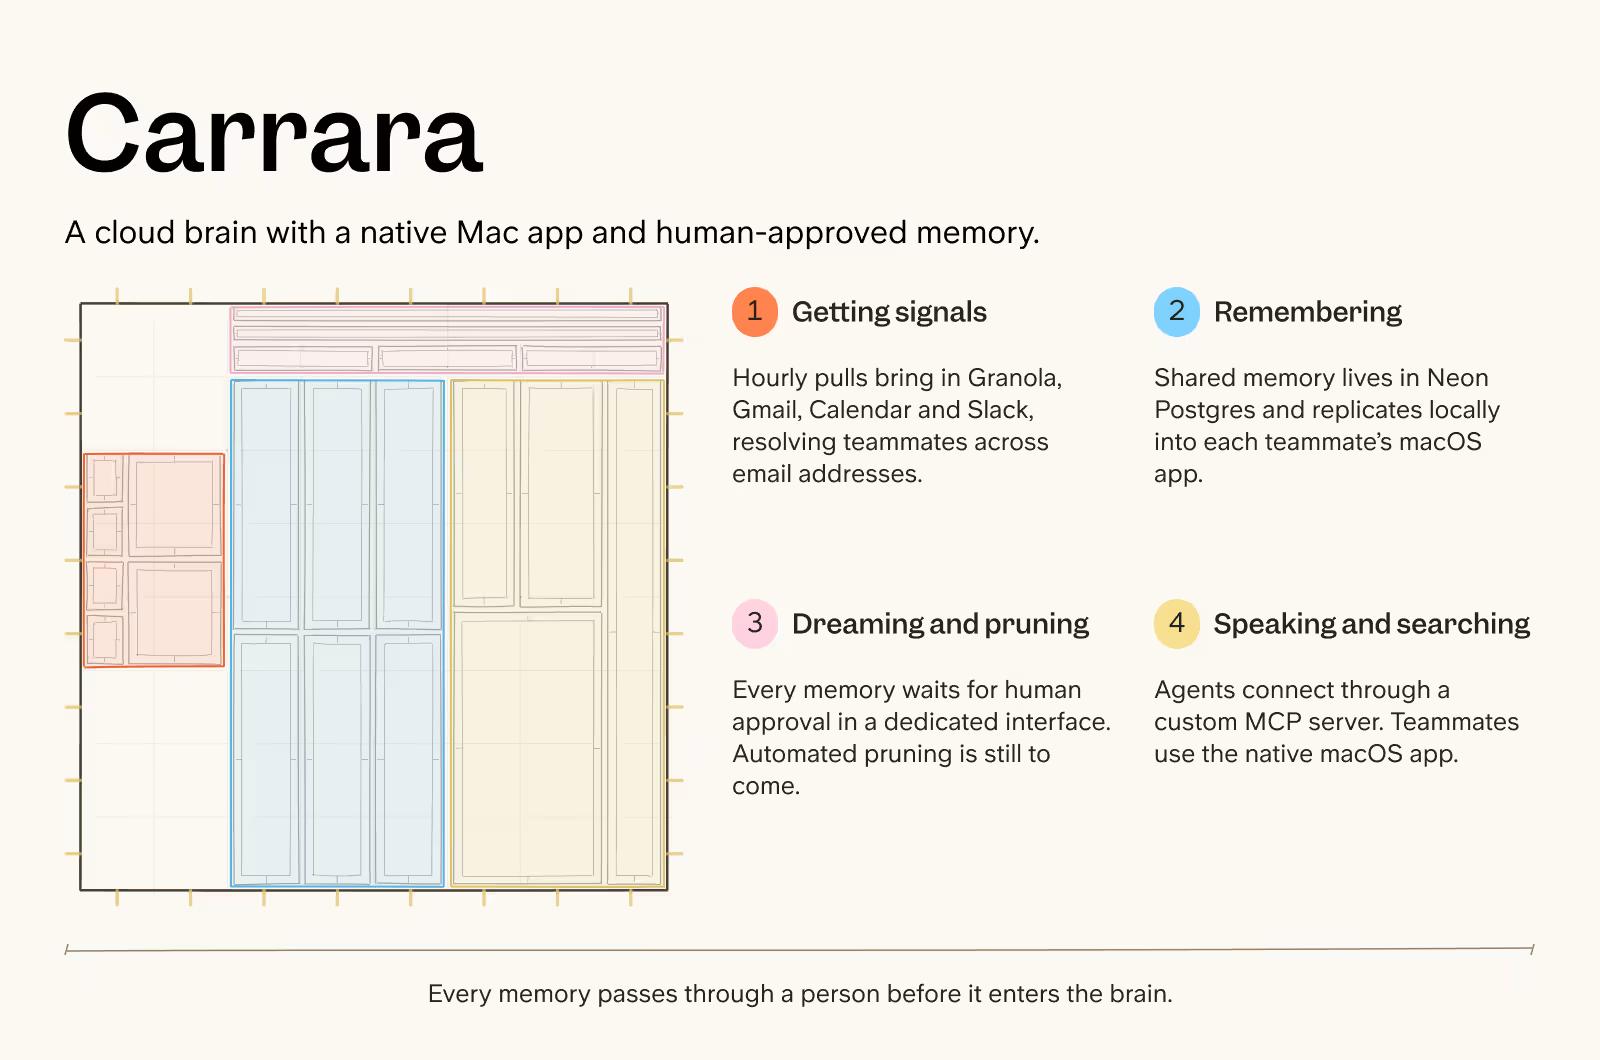
Carrara ist ein Cloud-Brain, das in eine native Mac-App repliziert wird, wobei jede Erinnerung von einem Menschen freigegeben wird, bevor sie ins Brain gelangt.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Jede Stunde zieht Carrara Daten aus Granola, Gmail, Kalender und Slack und ordnet jedes Teammitglied über mehrere E-Mail-Adressen hinweg zu. Composio erleichtert das Hinzufügen neuer Quellen. |
| Erinnern | Das gemeinsame Gedächtnis liegt in Neon Postgres, während eine native macOS-App es für jedes Teammitglied lokal repliziert. |
| Träumen und Ausmisten | Nichts gelangt ohne Prüfung ins Brain. Eine eigene Freigabeoberfläche sorgt dafür, dass jede Erinnerung von einem Menschen genehmigt ist. Automatisiertes Ausmisten kommt erst noch. |
| Sprechen und Suchen | Agenten verbinden sich über einen eigenen MCP-Server, während Teammitglieder die native macOS-App nutzen. |
Kosten und Eignung. Frühe Phase; Preise nicht öffentlich. Die interessante Wette ist das Review-first-Design: Es nimmt ein langsameres Wachstum des Brains in Kauf, damit nie etwas gespeichert wird, das ein Mensch nicht gesehen hat.
10. Slite Agent
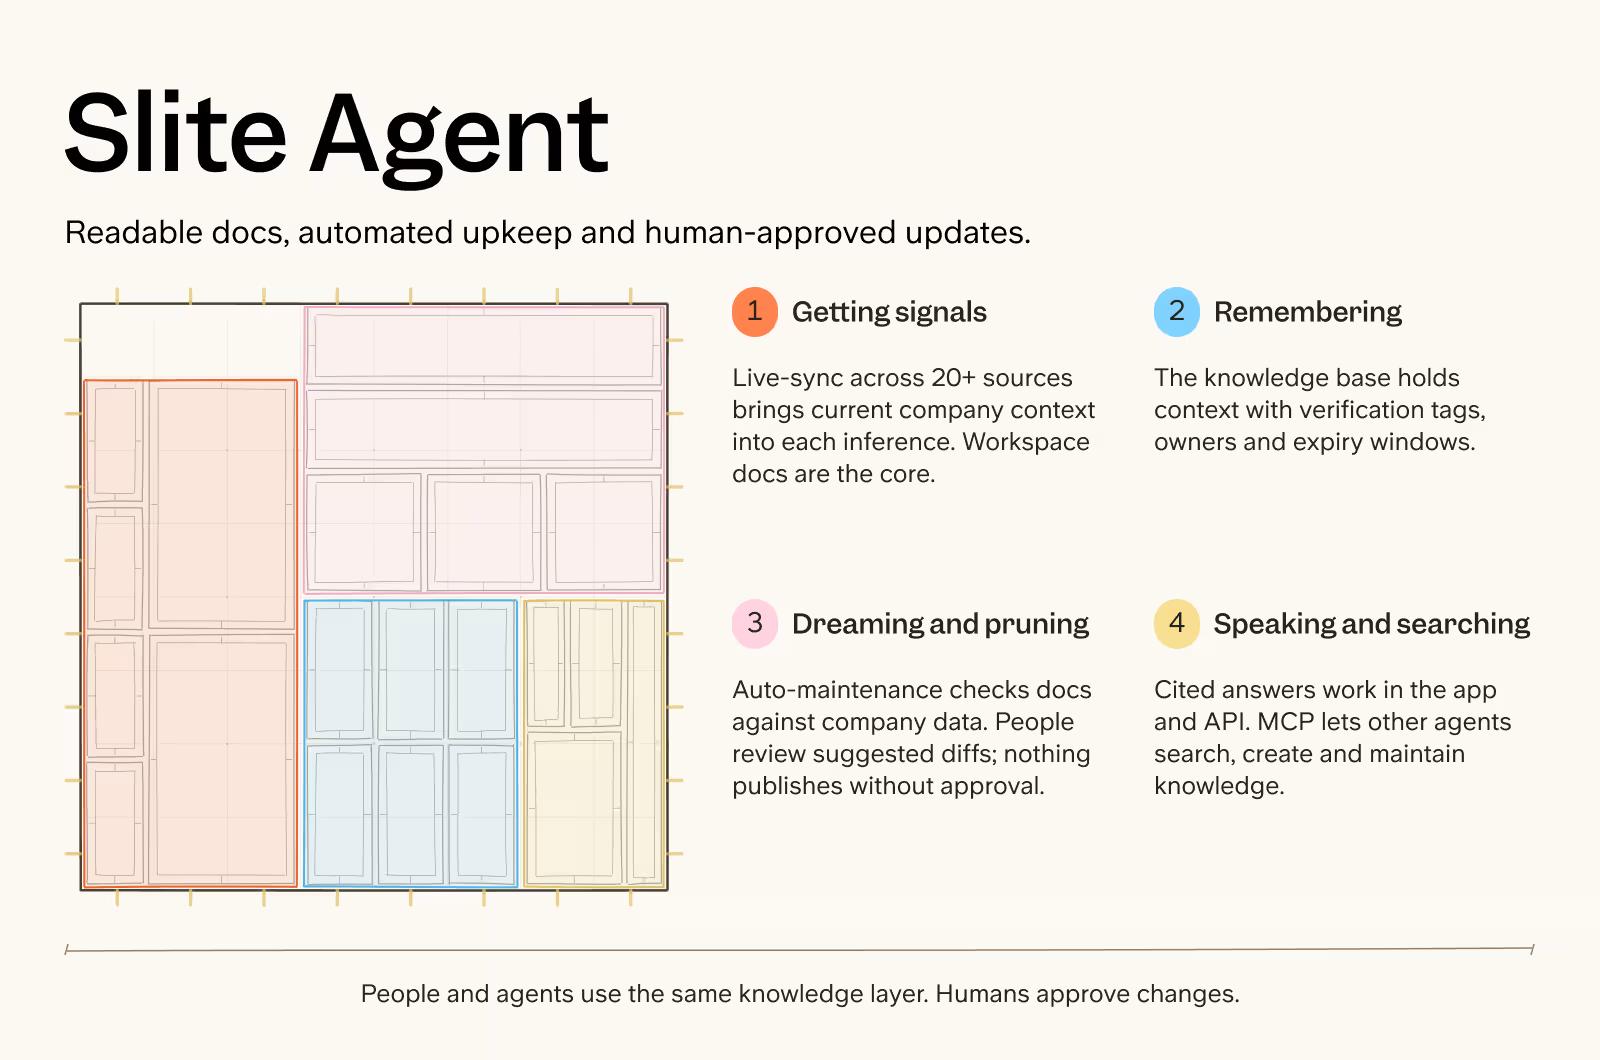
Slite behält die Dokumente, die Menschen ohnehin nutzen, und ergänzt sie um Prüfung, Ablauf, Wartung und Antworten mit Quellenangaben. Es ist unser eigenes Produkt. Lesen Sie diesen Eintrag deshalb als die Designentscheidungen, die wir getroffen haben, und nicht als Urteil.
| Komponente | Was zum Einsatz kommt |
|---|---|
| Signale erfassen | Slite Agent synchronisiert live über mehr als 20 Quellen, Slack, Drive, Notion, GitHub, Jira und weitere, und kann so den aktuellsten Unternehmenskontext in jede Inferenz einbringen. Dokumente und Anhänge im Workspace bilden den Kern. |
| Erinnern | Menschen und Agenten legen Kontext in Slites Wissensdatenbank ab, mit Verifizierungs-Tags, Verantwortlichen und Ablauffristen, die den Status klar machen. Die Dokumente bleiben der Speicher. |
| Träumen und Ausmisten | Mit der Auto-Wartung prüft Slite Ihre Dokumente regelmäßig anhand der übrigen Unternehmensdaten auf Fakten. Vorgeschlagene Aktualisierungen erscheinen als nebeneinanderstehende Diffs in einer Triage-Ansicht, in der Sie entscheiden, was sich ändert. Nichts wird ohne Freigabe veröffentlicht. |
| Sprechen und Suchen | Slite Agent antwortet mit Quellenangaben in der App und per API und stuft nicht verifizierte Quellen herab. Über seinen MCP-Server können auch andere Agenten Wissen durchsuchen, erstellen und pflegen. |
Kosten und Eignung. Abonnement pro Nutzer. Gebaut für Teams von 50 bis 500 Personen, die ein Company Brain wollen, das sich selbst pflegt und für Menschen lesbar bleibt, ohne dass der Kontext in einer Plattform landet, die sie nicht verlassen können.
Worin sich die Menschen einig sind, die Company Brains bauen
Die oben genannten Unternehmen sind sich in fast allem uneins: Abrufstrategie, Graph oder kein Graph, wie viel automatisiert wird. In den untersuchten Tools haben wir fünf verschiedene Reranker, drei Suchphilosophien und keinen gemeinsamen Benchmark gefunden.
Aber bei vier Dingen sind alle unsere Gesprächspartner zum selben Ergebnis gekommen.
- Sie werden das Company Brain für immer pflegen. Bei Slite melden sich regelmäßig Unternehmen, die bereits versucht haben, intern ein Company Brain zu bauen, und das Schwierigste ist immer die Wartung. Ein selbst gebautes Brain sind eigentlich zwei Aufgaben: den Inhalt zu kuratieren und das System neu zu architektieren, während sich das Feld bewegt. Gorgias kann sich beides leisten, aber für die meisten Teams ist die zweite Aufgabe die, die niemand einplant.
- KI ist nicht so weit, ohne Aufsicht in Ihr Unternehmenswissen zu schreiben. Automatisch erzeugtes Wissen funktioniert in persönlichen Brains, weil man mit sich selbst keine Konflikte hat. Unternehmenskontext ist anders: Agenten scheitern daran, einen abgegrenzten Plan von einer langen, vermeintlich maßgeblichen Slack-Diskussion über eine mögliche Änderung zu unterscheiden. Deshalb setzt jedes Unternehmen, das eine Company-Brain-Lösung anbietet, standardmäßig auf menschliche Triage: Pletor baut einen Posteingang für Änderungen, Gorgias führt jede Korrektur am Graphen über einen geprüften Pull Request, die Agenten von Sylph können ihre eigenen Entwürfe nicht freigeben, Carrara genehmigt jede Erinnerung, und wir haben Agent Triage in Slite eingebaut, bevor wir den Agent ausgeliefert haben.
- Die Erfassung muss dort stattfinden, wo die Arbeit passiert. Selbst die überzeugtesten Nutzer von Wissensdatenbanken haben uns gesagt, dass sie sie nicht dauerhaft füttern konnten. „Man muss sehr gezielt dafür sorgen, die Maschine zu füttern, und selbst mit den besten Absichten, wenn ich versucht habe, das voranzutreiben, habe ich es auch nicht getan", sagte Glen Sykes, Chief Product Officer bei Spoor. Deshalb wandert die Erfassung in die Arbeit selbst: Gorgias wertet seine eigenen Gesprächsverläufe aus, Pletor leitet Änderungen aus Chats ab, und Slite Agent beobachtet die Aktivität in verbundenen Tools, statt darauf zu warten, dass jemand etwas aufschreibt.
- Menschen werden dem Brain weiter Fragen stellen. Agenten werden mehr stellen. mem0, Guru und Slite haben dieses Jahr alle MCP-Server veröffentlicht, und Gorgias stellt einen für Code-first-Teams bereit. Sobald ein Unternehmen echte Agenten-Workflows betreibt, übersteigen die Agentenabfragen die menschlichen um Größenordnungen.
Welches Company Brain brauchen Sie?
Drei Fragen entscheiden das meiste: wie groß Ihr Team ist, was Ihnen am meisten Sorgen macht und wer das Brain intern verantworten würde.
| Wenn | Wählen Sie | Warum |
|---|---|---|
| Entwickler, die Freude daran hätten, höchstens 50 Personen, und die Kosten sind die Sorge | Selbst gehostet (GBrain, Sylph, selbst gebaut) | Sie haben die Entwickler und die Lust darauf. Bauen Sie es, besitzen Sie es, zahlen Sie fast nichts. |
| Entwickler, höchstens 50, und falsche Antworten sind die Sorge | Memory-SDKs (mem0, Zep, Letta) plus eigenes Retrieval-Tuning | Wenn Sie wegen der Genauigkeit nachts wach liegen, wollen Sie den Retrieval-Stack selbst in der Hand haben. |
| Entwickler, aber mehr als 50 Personen | Dedizierte Company Brains | Ihr Team könnte es bauen, aber in dieser Größe hat niemand die Kapazität, es auch zu warten. |
| Der Einrichtungsaufwand ist die Sorge | Dedizierte Company Brains | Dedizierte Brains sind schnell einsatzbereit geworden, und Ihr Kontext gehört auch in einem Jahr noch Ihnen. |
| Es am Leben zu halten ist die Sorge | Dedizierte Company Brains | Die Wartung ist es, was Sie beunruhigt. Wählen Sie die Kategorie, die sie automatisiert. |
| Wer was sehen darf, ist die Sorge | Dedizierte Company Brains | Berechtigungen müssen in die Schicht eingebaut sein und dürfen nicht von einer Plattform geerbt werden, die Sie nicht verlassen können. |
| Niemand Technisches, es muss einfach funktionieren | Dedizierte Company Brains | Niemand wird sich mit YAML-Dateien herumschlagen. Sie brauchen etwas, das am Tag der Anmeldung funktioniert. |
| Ein paar technische Leute, keine Kapazität, die Kosten sind die Sorge | Selbst gehostet mit geringem Aufwand (GBrain, Sylph) | Schlanke Einrichtung, einfache Dateien, nahezu keine Betriebskosten, ohne dass es zum Vollzeitjob für jemanden wird. |
Wofür Sie sich auch entscheiden: Behandeln Sie Kontext-Souveränität als Anforderung. Das Company Brain muss eine eigene Schicht sein. Es sitzt oberhalb der Plattformen und der Modelle und schuldet keinem von beiden Loyalität.
Selbst bauen oder kaufen: fünf Architekturfragen, die Sie zuerst klären sollten
Bevor Sie sich fürs Bauen entscheiden: Es gibt fünf Architekturentscheidungen, die jedes Team trifft, ob es baut oder kauft.
Wo liegen die Erinnerungen des Brains: in einer Datenbank oder in Dateien?
Das Speicher-Backend ist die am wenigsten differenzierende Entscheidung im Stack. Teams, die ihr eigenes Brain gebaut haben, haben es auf einfachem Markdown in einem Git-Repo, auf Objektspeicher und auf Postgres betrieben und sind zwischen diesen gewechselt, ohne die Struktur des Wissens anzutasten.
Postgres kommt als Lösung vor: Es ist ein Dateisystem, solange jeder Eintrag einen Titel, eine Beschreibung und einen Verantwortlichen trägt.
Womit Sie leben werden, ist die Form des Gedächtnisses und die Kontextschicht, die es Menschen und Agenten bereitstellt.
Wenn Sie bauen, wählen Sie, was Ihr Team betreiben kann. Wenn Sie kaufen, fragen Sie, ob Ihr Kontext als einfache Dateien exportierbar ist, denn das hält das Brain in Ihrer Hand.
Strukturierte Datensätze oder ein Wissensgraph, und wo liegt die Quelle der Wahrheit?
Die Trennung richtet sich danach, wem der Fakt gehört.
Systemeigene Entitäten wie Kunden, Tabellen und Kennzahlen bleiben in dem System, das sie erzeugt, und das Brain verweist darauf, statt sie zu kopieren.
Wissen, das Menschen gehört, etwa Entscheidungen, Prozesse und Definitionen, gehört in gepflegte Dokumente mit einem Status, den ein Mensch gesetzt hat.
Diese gepflegte Wissensdatenbank ist die Quelle der Wahrheit, und der Abruf liest zur Abfragezeit beides.
Was Sie nicht brauchen, ist ein gespeicherter Graph als dritte Quelle der Wahrheit. Er veraltet mit jeder Umstrukturierung, und das ist der Grund, warum wir sagen, dass Sie keinen Kontextgraphen brauchen.
Auch die Entwickler, mit denen wir gesprochen haben, sind sich bei Graphen nicht einig: Manche haben ihre Architektur auf zeitliche Graphen gewettet, manche haben einen von Hand gebaut, manche liefern keinen.
Wer darf was sehen?
Sobald das gesamte Team und seine Agenten aus demselben Brain schöpfen, müssen Sie entscheiden, wer welche Dokumente sieht. Menschen konnten schon immer Dateien öffnen, die nicht für sie gedacht waren, aber ein Agent durchsucht alles, was er erreichen kann.
Das Muster, das funktioniert, ist, das Brain über eine einzige Schnittstelle bereitzustellen, typischerweise einen MCP-Server, und jedem Agenten eine Zugriffsstufe zu geben, sodass ein kundennaher Agent nie Finanzdaten berührt.
Bauen Sie, wenn Sie Berechtigungen über jede Quelle hinweg selbst abbilden können. Kaufen Sie, wenn sie aus den Tools übernommen werden sollen, die Sie bereits nutzen.
Berechtigungen waren in unserer Umfrage mit 63 % das zweitgrößte Bedenken, und unser Leitfaden zu Zugriffskontrolle für KI-Agenten behandelt die Muster ausführlich.
Wer sorgt dafür, dass es stimmt?
Ein Company Brain ohne Verantwortlichen ist wie der Kühlschrank im Büro. Alle stellen Dinge hinein, niemand fühlt sich dafür zuständig, das Verdorbene wegzuwerfen, und nach ein paar Monaten traut man nichts mehr darin.
Jedes Brain, das heute funktioniert, landet bei derselben Antwort: Die KI schlägt vor, ein benannter Verantwortlicher gibt frei, wie bei einem Pull Request für Wissen.
Wenn zwei Änderungen konkurrieren, entscheidet der Dokumentverantwortliche, was übernommen wird.
In Slite wird das auf Wartungsebene eingerichtet, mit einem Verantwortlichen pro Dokument und einer Kommentarebene, um bestimmte Prüfer zuzuweisen.
Bauen Sie, wenn Sie bereit sind, diesen Prüfprozess noch lange nach dem Start zu betreiben. Kaufen Sie, wenn niemand diese Zeit hat.
Den vollständigen Workflow, von der Verantwortung bis zu den Prüfwarteschlangen, finden Sie in unserem Leitfaden zur Wartung von Wissensdatenbanken.
Wo hört das Selbstbauen auf, sinnvoll zu sein?
Ein Team aus vier Personen kann in etwa vier Wochen ein funktionierendes Brain bauen, aber meist erst nach einem Jahr, in dem es herausgefunden hat, was es will, und mit Entwicklern, die schon agentische Systeme ausgeliefert haben.
Die funktionierende Demo ist der einfache Teil.
Das Bauen besteht aus zwei Aufgaben:
- den Inhalt zu kuratieren,
- und das System neu zu architektieren, während sich das Feld bewegt.
Realistisch braucht ein selbst gebautes Brain, das Bestand hat, 500 oder mehr Personen und einige Entwickler, die sich dauerhaft darum kümmern.
Darunter bedeutet die Zeile „Selbst gehostet" in der Tabelle oben ein schlankes Setup mit einfachen Dateien und kein Produkt, das Ihr Team ständig neu architektiert.
Für kleinere Teams ist Selbstbauen übertrieben, selbst wenn alle Git und Claude beherrschen.
Wenn eine Wissensdatenbank das Company Brain ist
Eine Frage beantwortet keiner der Artikel über Company Brains: Sitzt das Brain auf Ihrer Wissensdatenbank, oder kann die Wissensdatenbank das Brain sein?
Jeder Anbieter behauptet seine eigene Schicht. Unsere Antwort, und der Grund, warum wir Slite Agent so gebaut haben, wie wir es getan haben, lautet: Für die meisten Teams sind die Dokumente, denen die Menschen ohnehin vertrauen, der richtige Speicher, solange drei Dinge zutreffen.
Jedes Dokument trägt einen Status, den ein Mensch gesetzt hat: verifiziert, veraltet, ablaufend.
Etwas prüft diese Dokumente an der Realität und schlägt Korrekturen vor, ohne sie selbstständig zu veröffentlichen. Und Agenten erreichen über MCP dieselbe verifizierte Schicht wie die Menschen, mit denselben Berechtigungen.
Das gibt Ihnen die automatisierte Wartung der dedizierten Familie, die Lesbarkeit einfacher Dokumente und keinen der Lock-ins der etablierten Suite-Anbieter.
Wenn das nach dem Brain klingt, das Ihr Team braucht, buchen Sie eine Demo oder beginnen Sie mit Slite Agent. Und wenn Sie die vollständigen Interviews hinter diesem Artikel lesen möchten, finden Sie sie in Company Brain 101.
FAQ
Ist Glean ein Company Brain?
Glean ist eine Enterprise-Suche mit KI-Schicht: Sie findet und fasst zusammen, was in Ihren Tools bereits existiert. Sie pflegt oder korrigiert dieses Wissen nicht und hält Ihren Kontext innerhalb ihrer Plattform. Das macht sie zu einem etablierten Suite-Anbieter und zu keiner unabhängigen Company-Brain-Schicht. Lesen Sie dazu unseren Glean-Test.
Gibt es Open-Source-Company-Brains?
Ja. GBrain und Sylph speichern das Brain als einfache Dateien in Git. mem0, Graphiti (Zep) und Letta sind Open-Source-Memory-Schichten, die Sie selbst hosten können. Sie alle überlassen die Wartung Ihrem Team.
Wie bleibt ein Company Brain aktuell?
Durch die Komponente Träumen und Ausmisten: Konsolidierungsläufe, zeitlicher Verfall, Abweichungserkennung gegenüber Live-Tools und menschliche Prüfwarteschlangen. Hier unterscheiden sich die Tools in dieser Liste am stärksten, und es ist die Komponente, die entscheidet, ob das Brain zu dem veralteten Wiki wird, das es ersetzen sollte.
Was kostet Company-Brain-Software?
Selbst gehostete Optionen sind abgesehen von Modell- und Hosting-Kosten kostenlos, aber die Wartung bleibt an Ihrem Team hängen; in unserer Umfrage haben 27 % der Teams ein selbst gebautes Brain aus diesem Grund aufgegeben. Memory-SDKs werden nutzungsbasiert abgerechnet. Dedizierte Company Brains sind Abonnements pro Nutzer.
Reicht Notion für ein Second Brain?
Für ein persönliches Second Brain oft ja. Für ein Company Brain deckt Notion die Komponente Erinnern ab und kaum mehr: Nichts prüft die Seiten an der Realität, und Suche und Berechtigungen bleiben innerhalb der Plattform. Das ist der oben beschriebene Kompromiss bei den etablierten Suite-Anbietern.
Kann ein Company Brain on-prem laufen?
Die selbst gehosteten Muster (GBrain, Sylph, ein selbst gebautes Brain wie das bei Gorgias) und die Open-Source-Memory-SDKs können das. Dedizierte Company Brains sind meist Cloud-Produkte. Fragen Sie deshalb jeden Anbieter nach Datenresidenz und danach, ob Ihr Kontext als einfache Dateien exportierbar ist.
Braucht man einen Wissensgraphen, um ein Company Brain zu bauen?
Nein. Manche Tools in dieser Liste betreiben einen, etwa Zeps Graphiti und das Gorgias-Brain, während GBrain und Sylph einfache Dateien nutzen. Ein gespeicherter Graph ist eine Abrufentscheidung und keine Voraussetzung, und er braucht ständige Pflege, wenn sich das Unternehmen verändert. Agentisches Retrieval über eine gepflegte Wissensdatenbank liefert dieselben Multi-Hop-Antworten ohne den Pflegeaufwand.